אצווה (Batch)
הגדרה
אצווה היא קבוצת דוגמאות-אימון קטנה שמעובדת יחד בצעד אחד של אימון — במקום לעדכן את המודל אחרי כל דוגמה בודדת, או אחרי כל מערך-הנתונים בבת אחת.
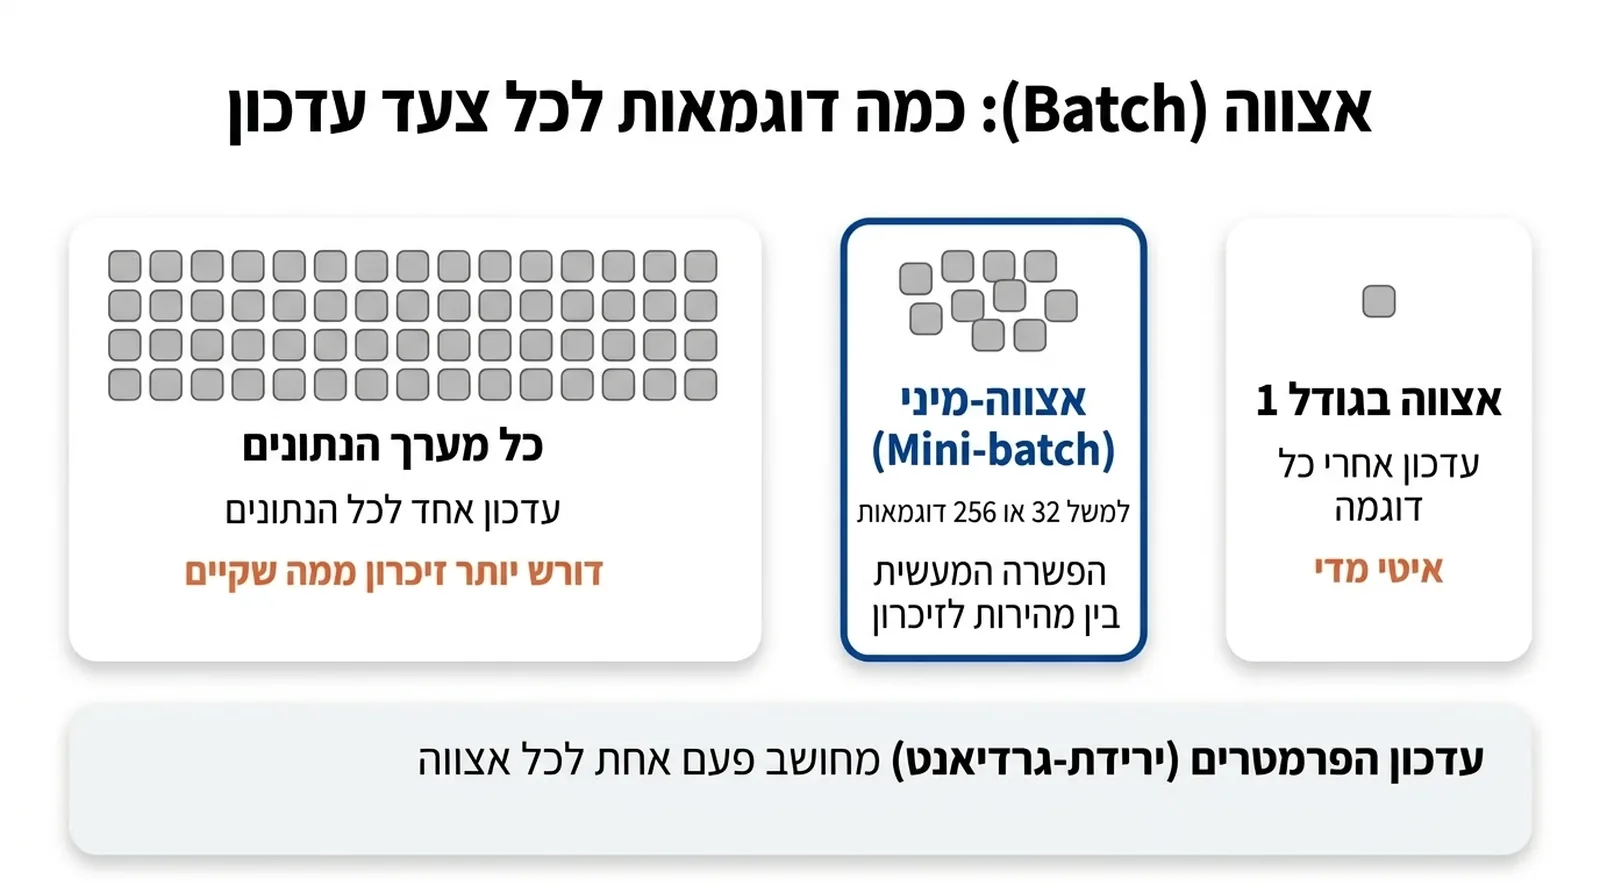
עיבוד כל דוגמה בנפרד יהיה איטי מדי; עיבוד כל מערך-הנתונים בבת אחת ידרוש יותר זיכרון ממה שקיים. אצווה היא הפשרה המעשית — למשל 32 או 256 דוגמאות יחד — שמאזנת בין מהירות לזיכרון זמין. גם עדכון-הפרמטרים עצמו (ירידת-גרדיאנט) מחושב פעם אחת לכל אצווה, לא לכל דוגמה בנפרד — כך שגודל-האצווה קובע ישירות כמה פעמים המודל "מתעדכן" באותה כמות-נתונים.
בעולם מודלי-השפה-הגדולים, גדלי-האצווה גדלו בסדרי-גודל: במקום עשרות דוגמאות, מודלים גדולים מאומנים היום לעיתים עם אצוות שמכילות מיליוני טוקנים (יחידות-טקסט) בבת אחת, מפוזרות על פני אלפי מעבדים גרפיים שעובדים במקביל. כדי להגיע לאצווה ענקית כזו בלי לחרוג מזיכרון-הכרטיס הבודד, מפתחים משתמשים בטכניקה שנקראת "צבירת-גרדיאנטים" (Gradient Accumulation) — מחשבים כמה אצוות קטנות בזה-אחר-זה, וצוברים את הגרדיאנטים שלהן לפני שמעדכנים את הפרמטרים בפועל, כאילו הן היו אצווה גדולה אחת.
גודל-האצווה הוא היפר-פרמטר משמעותי: אצווה גדולה יותר מנצלת חומרה (כמו GPU) ביעילות רבה יותר אך דורשת יותר זיכרון, ומשפיעה גם על יציבות תהליך האימון ועל האיכות הסופית של המודל. באופן שמפתיע רבים, אצווה גדולה-מדי לא תמיד עדיפה: מחקרים מצאו שאצוות קטנות-יותר יחסית מכניסות "רעש" מועיל לתהליך האימון, שלעיתים עוזר למודל להימנע ממינימום-מקומי גרוע ולהכליל טוב יותר לנתונים חדשים בסופו של דבר.
במקרה הקיצוני ביותר — אצווה בגודל 1, כלומר עדכון אחרי כל דוגמה בודדת — נקרא "ירידת-גרדיאנט סטוכסטית טהורה", ובקיצון ההפוך, אצווה שכוללת את כל מערך-הנתונים בבת אחת, נקרא "ירידת-גרדיאנט אצווה מלאה" (Batch Gradient Descent). כמעט כל אימון מעשי היום נמצא איפשהו בין שני הקיצונים הללו — "אצווה-מיני" (Mini-batch) בגודל שנבחר במפורש כפשרה מכוונת, ולא בכדי המונח "אצווה" בשימוש היומיומי בתחום מתייחס כמעט תמיד לגודל-האצווה-המיני, לא לאף אחד מהקיצונים.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות