Blackboard Architecture (ארכיטקטורת לוח-מחיקה)
הגדרה
ארכיטקטורת לוח-מחיקה היא תבנית-תכנון ותיקה מבינה מלאכותית שבה כמה מודולים עצמאיים ("מקורות-ידע") קוראים וכותבים למבנה-נתונים משותף — "לוח-המחיקה" — במקום לתקשר ישירות זה עם זה.
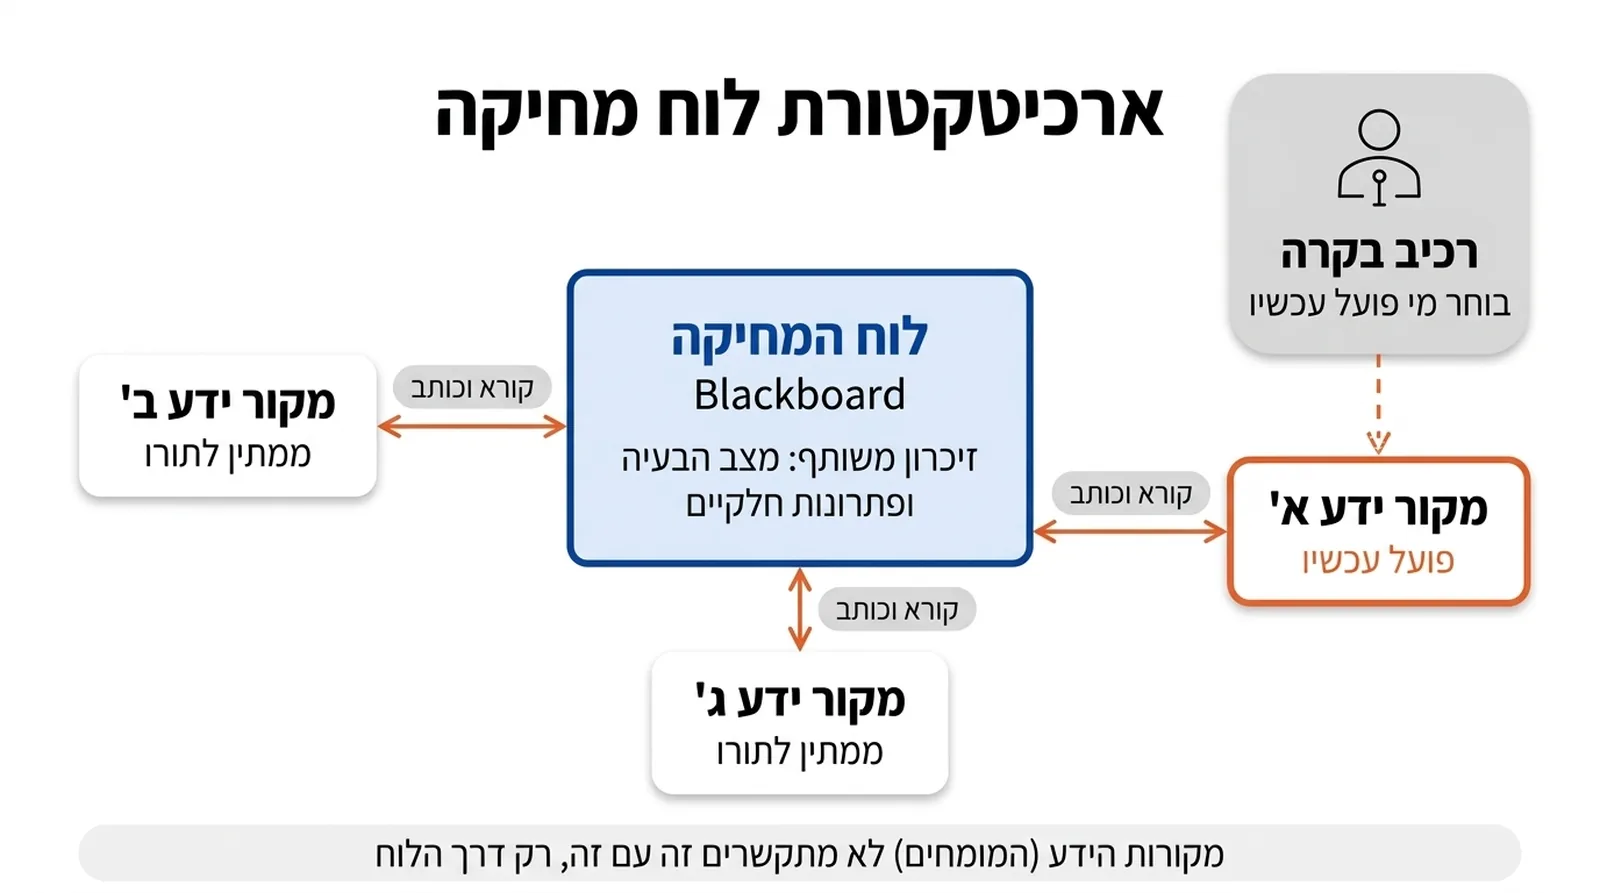
הגדרה: שלושת הרכיבים של ארכיטקטורת-לוח-מחיקה
ארכיטקטורת לוח-מחיקה (Blackboard Architecture / Blackboard System) היא תבנית-תכנון ותיקה מתחום הבינה-המלאכותית, שבה כמה מודולים עצמאיים — הקרויים "מקורות-ידע" (Knowledge Sources) — קוראים וכותבים למבנה-נתונים משותף אחד, "לוח-המחיקה" (Blackboard), במקום לתקשר ישירות זה עם זה. השם שאול במפורש מהתמונה של קבוצת-מומחים שעומדת סביב לוח-מחיקה משותף בכיתה: כל מומחה תורם את מה שהוא יודע כשהוא רואה שהוא יכול לקדם את הפתרון, בלי לדבר ישירות עם שאר המומחים — הוא רק קורא מה שכבר כתוב על הלוח, ומוסיף עליו. הארכיטקטורה מורכבת משלושה רכיבים מוגדרים: "לוח-המחיקה" עצמו — זיכרון גלובלי-משותף ומובנה שמכיל את מצב-הבעיה, פתרונות-חלקיים והצעות, מאורגן לרוב בכמה "רמות-הפשטה" מקבילות; "מקורות-הידע" — מודולים מתמחים, כל אחד עם ייצוג-פנימי וידע-תחום משלו, שיכולים לקרוא מהלוח ולהוסיף לו מידע כשהם "מזהים" שיש להם תרומה רלוונטית לתוכן שכבר מופיע עליו; ו"רכיב-בקרה" (Control Shell) — מתזמן שמחליט איזה מקור-ידע יופעל הבא, בדרך-כלל לפי היוריסטיקות שמדרגות עד כמה כל מקור-ידע-זמין רלוונטי כרגע לפתרון הבעיה, ומכריע בכל שלב איזו פעולה תקדם את הפתרון הכי הרבה יחסית למאמץ-החישוב שהיא דורשת.
המקור: Hearsay-II, קרנגי-מלון, ותוכנית ה-SUR של DARPA
המקור ההיסטורי המדויק של הדפוס הוא פרויקט Hearsay-II, מערכת-זיהוי-דיבור שפותחה באוניברסיטת קרנגי-מלון (CMU) כחלק מתוכנית "מחקר-הבנת-דיבור" (Speech Understanding Research, SUR) בת-חמש-השנים שמימנה DARPA משנת 1971, בהשתתפות מוסדות נוספים כמו BBN, IBM, ומכון-המחקר של סטנפורד (SRI). ריי רדי (Raj Reddy), שהצטרף ל-CMU ב-1969 והחל שם לפתח מערכות-זיהוי-דיבור-רציף מוקדמות (Hearsay-I, שנחשבת לאחת המערכות הראשונות ביכולת-זיהוי-דיבור-רציף בכלל), היה בין החוקרים המרכזיים שהובילו את Hearsay-II — המערכת שממנה, לדברי אנציקלופדיית-ויקיפדיה שמתעדת את קריירתו, "המודל של לוח-המחיקה לתיאום בין מקורות-ידע מרובים אומץ על-פני מגוון רחב של יישומי בינה-מלאכותית". הבעיה שהארכיטקטורה נועדה לפתור הייתה קונקרטית מאוד: זיהוי-דיבור דורש שילוב בין-זמני של ידע פונטי, לקסיקלי, תחבירי, סמנטי ופרגמטי — תחומי-ידע נפרדים לחלוטין זה מזה, שכל אחד מהם עשוי להצביע על פרשנות שונה לאותו קטע-אות — וללא מנגנון-תיאום מרכזי-אך-לא-נוקשה, אף מודול בודד לא יכול היה להכריע לבד באי-ודאות הגבוהה שמאפיינת אות-דיבור אמיתי, מלא ברעש ובעמימות.
איך זה שונה מתקשורת-ישירה בין סוכנים
מה שמייחד את ארכיטקטורת-לוח-המחיקה מתבניות-תיאום אחרות בין כמה מודולים הוא בדיוק העדר-התקשורת-הישירה: מקורות-הידע אינם "שולחים הודעות" זה לזה ואינם מודעים כלל למי-עוד-פועל במערכת — הם רק קוראים וכותבים ללוח המשותף, וזה מאפשר להוסיף או להסיר מקור-ידע בלי לשנות שום מודול אחר, כל עוד הוא יודע לקרוא ולכתוב למבנה-הנתונים המשותף באותה שפה. לוח-הבקרה הוא זה שנושא את מלוא האחריות לתיאום: הוא בוחר, בכל שלב, איזה מקור-ידע "הכי-רלוונטי" כרגע לקדם את הפתרון, ולפעמים משנה כיוון לחלוטין כשמקור-ידע חדש חושף פרשנות-חלופית טובה יותר לנתונים הקיימים על הלוח — התנהגות שקרובה יותר לחיפוש-היוריסטי-מונחה, שמתקדם בקפיצות ולא בקו ישר, מאשר לצינור-עבודה קבוע-מראש שמניח מלכתחילה סדר-פתרון ליניארי וידוע. תהליך-הפתרון האופייני מתואר לרוב כ"היפותזה-ובדיקה": מקור-ידע אחד כותב על הלוח השערה-חלקית (למשל, פרשנות-אפשרית של קטע-דיבור), ומקורות-ידע אחרים בודקים אם ההשערה הזו עקבית עם מה שהם יודעים מתחום-המומחיות שלהם-עצמם — עד שנוצרים, בהדרגה, "איים-של-אמינות" בפתרון שממשיכים להתרחב זה לתוך זה.
יישומים היסטוריים נוספים, אחרי זיהוי-דיבור
בעקבות Hearsay-II פותחו מסגרות-תכנות ייעודיות ליישום הדפוס במגוון תחומים: BB1, שפיתחה ברברה הייז-רות' (Barbara Hayes-Roth) ב-1985 במימון הצי האמריקאי (Office of Naval Research), הכלילה את מודל-הבקרה של הארכיטקטורה בהשראת מחקר על תכנון-אנושי-רב-משימתי — כיצד בני-אדם מתכננים ומבצעים כמה משימות-שלובות-זו-בזו במהלך נסיעה, למשל, ומעדכנים את התוכנית שלהם כשמתקבל מידע חדש; ו-GBB (Generic Blackboard Development System, 1986) הציעה סביבת-פיתוח כללית לבניית מערכות-לוח-מחיקה בלי לכתוב מחדש את רכיב-הבקרה מאפס בכל פעם. מעבר לזיהוי-דיבור, תיעוד-מוסמך מונה יישומים נוספים ומגוונים של הדפוס: זיהוי ומעקב אחר כלי-רכב, זיהוי מבני-חלבון, פענוח אותות-סונר, מסגרת-שפה בשם ACCORD לבעיות-תצורה מורכבות, ואפילו Copycat ו-Numbo — מערכות-חשיבה-אנלוגית של דאגלס הופשטטר (Douglas Hofstadter) שמדגימות שהדפוס לא הצטמצם לתחום צר אחד, אלא הפך לכלי-תכנון כללי לכל בעיה שדורשת שילוב-ידע ממקורות-מרובים ושונים-איכותית זה מזה, תחת אי-ודאות ובלי סדר-פתרון קבוע-מראש שניתן לתכנת מראש בקוד ליניארי. מה שמאחד את כל היישומים המגוונים האלה — מזיהוי-דיבור ועד חשיבה-אנלוגית — הוא שבכל אחד מהם הבעיה עצמה לא ניתנת לפתרון על-ידי מומחה-בודד עם ידע-אחיד: נדרש שילוב בין-תחומי, ורמת-האי-ודאות גבוהה מדי כדי לקבוע מראש, באופן קשיח, באיזה סדר בדיוק לצרוך את הידע השונה.
הדים מודרניים: איפה הרעיון מבצבץ שוב במערכות-AI של היום
עם עליית מערכות-רב-סוכניות מבוססות-מודלי-שפה גדולים, ההיגיון של ארכיטקטורת-לוח-המחיקה — תיאום דרך מצב-משותף במקום העברת-הודעות-ישירה בין נקודה לנקודה — מבצבץ שוב, גם אם לרוב בלי לשאת את השם ההיסטורי המקורי. מדריך-הארכיטקטורה של מיקרוסופט ל-Azure, למשל, מתעד תחת השם "תזמור-שיחת-קבוצה" (Group Chat Orchestration) דפוס שבו "כמה סוכנים פותרים בעיות, מקבלים החלטות, או מאמתים עבודה על-ידי השתתפות בשרשור-שיחה משותף שהם משתפים-פעולה דרכו" — כשמנהל-שיחה (Chat Manager) קובע מי מגיב הבא ומנהל מצבי-אינטראקציה שונים, מ"סיעור-מוחות שיתופי" ועד "שערי-איכות מובנים", בדומה מאוד לתפקיד-הבקרה שמילא רכיב-הבקרה בארכיטקטורת-לוח-המחיקה המקורית. ההבדל המהותי מהמקור נשאר: לוח-המחיקה ההיסטורי היה מבנה-נתונים סמלי ומובנה, שמקורות-ידע קראו וכתבו בו בפורמט מוגדר-מראש, ואילו "שיחת-הקבוצה" המודרנית היא לרוב שרשור-טקסט חופשי בשפה-טבעית — אבל עקרון-היסוד, קריאה-וכתיבה למצב-משותף במקום תקשורת-נקודה-לנקודה, וקבלת-החלטות דרך רכיב-בקרה מרכזי שבוחר מי "מדבר" הבא, נשארים זהים בעיקרם, גם חמישה עשורים אחרי Hearsay-II.
למה הארכיטקטורה נחשבה חדשנית בזמנה, ומה המחיר שלה
בשנות ה-70 של המאה ה-20, כשרוב מערכות-הבינה-המלאכותית תוכננו כתוכניות-ליניאריות עם רצף-שלבים קבוע, ארכיטקטורת-לוח-המחיקה הציגה רעיון שנתפס כמהפכני יחסית: אפשר לבנות מערכת שמורכבת ממודולים "עיוורים" זה לזה לחלוטין, שכל אחד מהם יכול להיכתב, להיבדק ולהשתפר בנפרד, ועדיין לקבל התנהגות-כוללת קוהרנטית בזכות תיאום דרך מבנה-נתונים משותף בלבד. זה אפשר לצוותי-מחקר שונים לפתח מקורות-ידע נפרדים במקביל, ולשלב אותם למערכת אחת בלי שאף אחד מהם יצטרך להבין את הקוד הפנימי של האחרים — יתרון-הנדסי משמעותי לפרויקט מחקר גדול כמו Hearsay-II, עם עשרות חוקרים מעורבים. המחיר המרכזי, שתועד גם בביקורת-אקדמית על הדפוס לאורך השנים, הוא סיבוכיות-הבקרה: ברגע שיש הרבה מקורות-ידע פוטנציאליים ולוח-מחיקה גדול, על רכיב-הבקרה להחליט מתוך מרחב-אפשרויות עצום איזה מקור-ידע להפעיל הבא, וההחלטה הזו-עצמה יכולה להפוך לצוואר-בקבוק חישובי ולנקודת-כשל-יחידה אם היא לא מתוכננת בקפידה — בדיוק כפי שבמערכות-רב-סוכניות מודרניות, מנגנון-הבקרה שמחליט "מי מדבר הבא" הוא לרוב הרכיב שהכי קשה לכוון נכון.
לוח-מחיקה מול מערכות-כללים: הבדל-בקרה מהותי
כדי להבין למה ארכיטקטורת-לוח-המחיקה נחשבה גישה נפרדת ולא רק וריאציה על שיטות-בקרה קיימות, שווה לנגד אותה מול "מערכות-כללים" (Production Systems) — תבנית-בקרה נפוצה-אף-היא בבינה-מלאכותית קלאסית, שבה אוסף-כללים מהצורה "אם-תנאי-מתקיים-אז-בצע-פעולה" נבדק שוב-ושוב מול מצב-עולם יחיד, וכלל אחד "זוכה" בכל סבב ומבצע את הפעולה שלו. בלוח-מחיקה, לעומת זאת, אין כלל "מנצח יחיד" שבוחר את עצמו — הבחירה מבוצעת באופן מפורש ומודע על-ידי רכיב-הבקרה, שמדרג את כל מקורות-הידע הזמינים לפי תרומה-צפויה ובוחר את הכי-מבטיח, ולא רק את הראשון-שמתאים לתנאי טכני. ההבדל הזה חשוב כי הוא מאפשר ללוח-מחיקה להתמודד טוב יותר עם בעיות שבהן אין "התאמה-ברורה" בין מצב לפעולה, אלא צריך לשקול-ולתעדף בין כמה כיוונים חלקיים-נכונים בו-זמנית — בדיוק מה שמאפיין זיהוי-דיבור, ומה שהופך את סגנון-הבקרה "האופורטוניסטי" (Opportunistic Scheduling) של לוח-המחיקה, שיכול לשנות כיוון-פתרון שלם ברגע שמידע חדש מגיע, לחיוני יותר ממערכת-כללים נוקשה יותר. במערכת-כללים קלאסית, שינוי-כיוון כזה קשה במיוחד כי הכלל שכבר "זכה" וביצע את הפעולה שלו אינו חוזר בקלות אחורה; בלוח-מחיקה, לעומת זאת, כל תרומה נשארת רק כהצעה-חלקית על הלוח, ומקור-ידע אחר תמיד יכול להגיב אליה, לערער עליה, או להציע פרשנות-חלופית — מה שהופך את התהליך כולו לגמיש יותר, גם אם המחיר הוא ריבוי-מצבי-ביניים שרכיב-הבקרה צריך לנהל ולתעדף בו-זמנית.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
שאלות נפוצות ❓
מה מקור השם "ארכיטקטורת לוח-מחיקה"?
מהתמונה של קבוצת-מומחים שעומדת סביב לוח-מחיקה משותף בכיתה — כל אחד תורם כשהוא רואה שהוא יכול לקדם את הפתרון, בלי לדבר ישירות עם השאר.
מהי המערכת ההיסטורית שממנה הדפוס נולד?
Hearsay-II, מערכת-זיהוי-דיבור שפותחה באוניברסיטת קרנגי-מלון במסגרת תוכנית ה-SUR של DARPA שהחלה ב-1971, בהובלת חוקרים כמו ריי רדי.
מה ההבדל בין ארכיטקטורת לוח-מחיקה לבין תקשורת-ישירה בין סוכנים?
במקום לשלוח הודעות זה לזה, כל מקור-ידע קורא וכותב רק למבנה-נתונים משותף — כך שניתן להוסיף או להסיר מודול בלי לשנות שום מודול אחר.
האם הדפוס עדיין בשימוש היום?
העיקרון שלו — תיאום דרך מצב-משותף — ממשיך להופיע במערכות-רב-סוכניות מודרניות, למשל בדפוסי "שיחת-קבוצה" שבהם כמה סוכני-AI משתפים-פעולה דרך שרשור-שיחה משותף.
האם הדפוס הוגבל לתחום זיהוי-הדיבור?
לא — הוא יושם גם בזיהוי-כלי-רכב, זיהוי מבני-חלבון, פענוח-סונר, בעיות-תצורה, ואף במערכות-חשיבה-אנלוגית, כתבנית-תכנון כללית לבעיות שדורשות שילוב-ידע ממקורות מרובים.