DPO (אופטימיזציית העדפה ישירה)
הגדרה
DPO היא שיטה מודרנית וחסכונית יותר מ-RLHF לכוונן מודל לפי העדפות אנושיות — משיגה תוצאה דומה בלי הצורך לאמן מודל-תגמול נפרד ותהליך למידת-חיזוק מורכב.
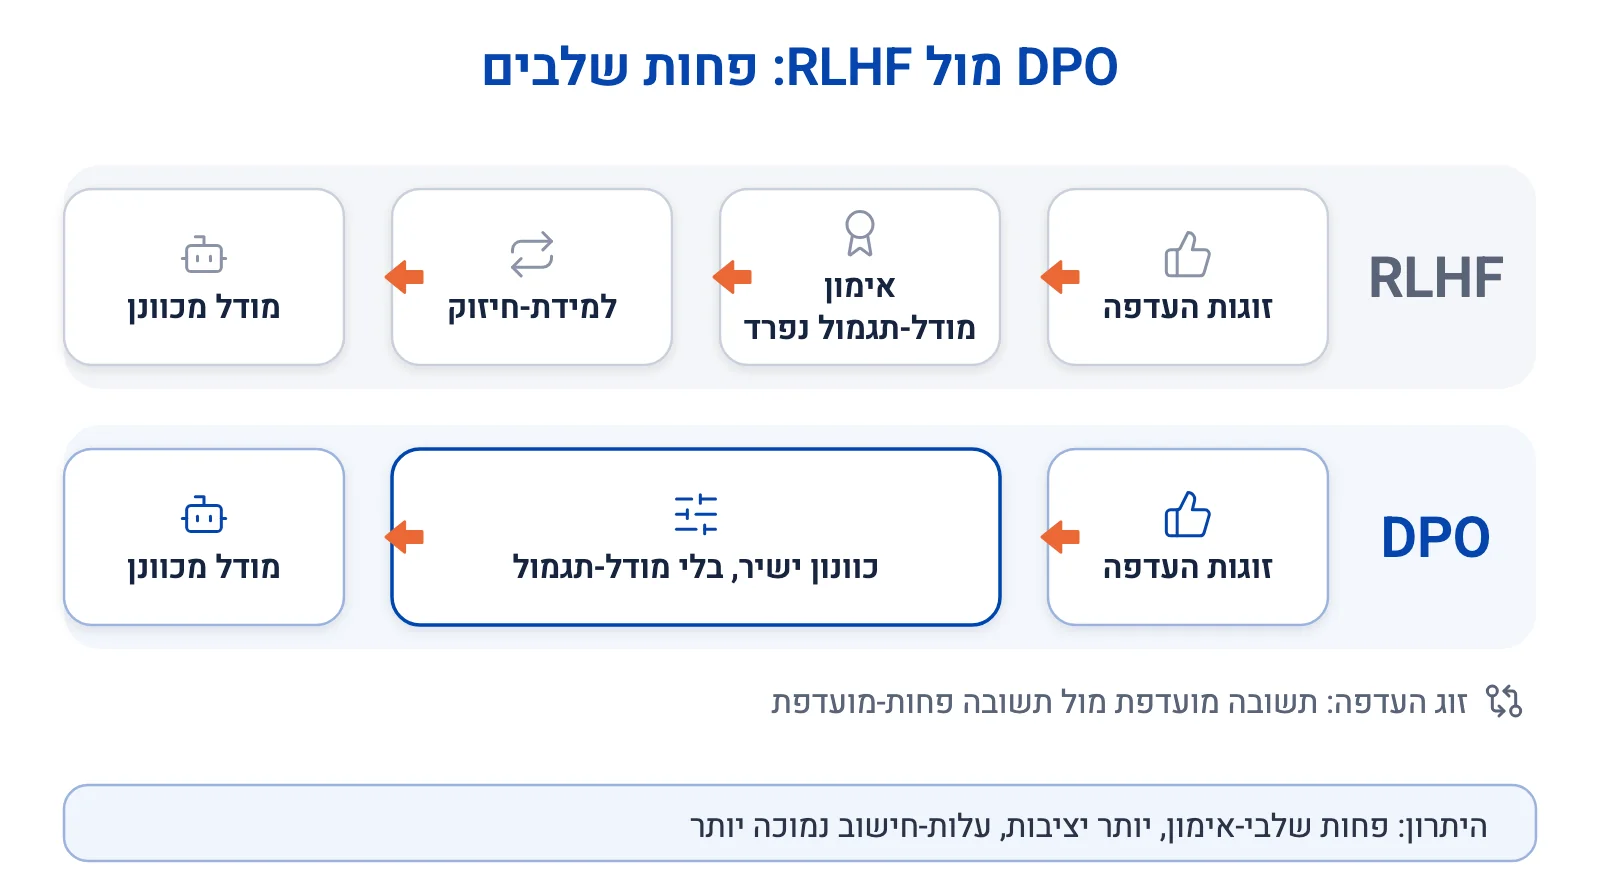
בעוד שלמידת-חיזוק מהעדפות אנושיות (RLHF — Reinforcement Learning from Human Feedback) דורשת שני שלבי-אימון נפרדים (מודל-תגמול, ואז למידת-חיזוק), אופטימיזציית העדפה ישירה (DPO — Direct Preference Optimization) משתמשת ישירות בזוגות "תשובה מועדפת / תשובה פחות-מועדפת" כדי לכוונן את המודל, בנוסחה מתמטית פשוטה יותר.
השיטה הוצגה במאמר מ-2023 שכותרתו-המשנה תמצתה את התובנה המרכזית מאחוריה: מודל השפה עצמו, מתברר, כבר "מכיל" בתוכו מודל-תגמול סמוי — כך שאפשר לדלג לגמרי על שלב אימון מודל-התגמול הנפרד.
היתרון המרכזי: פחות שלבי-אימון, יציבות רבה יותר, ועלות-חישוב נמוכה יותר — מה שהפך אותה לפופולרית בקרב חברות וקהילות קוד-פתוח שאין להן משאבי-חישוב של החברות הגדולות ביותר. בפועל, ארגון קטן יחסית יכול לכוונן מודל להעדפות ספציפיות בלי להקים תשתית-למידת-חיזוק מלאה, שדורשת מומחיות הנדסית ומשאבי-חישוב נוספים משמעותיים מעבר לאימון-הבסיס עצמו — הבדל שהופך DPO לנגישה בהרבה מ-RLHF המסורתי לצוותים קטנים.
נכון ל-2026, רבים ממודלי-השפה בעלי-המשקלים-הפתוחים המובילים מכווננים באמצעות DPO או גרסאות משופרות שלה, לא RLHF המסורתי — שינוי שהתרחש במהירות רבה יחסית מאז פרסום המאמר המקורי, ומדגים כמה מהר שיטות-אימון חדשות יכולות להשתלט על תעשייה שלמה כשהן פשוטות וזולות יותר משמעותית מהחלופה הקודמת.
דוגמה מוקדמת ובולטת ליישום: מודל Zephyr, שפיתחה קבוצה בהגינג-פייס (Hugging Face) ב-2023, הדגים שאפשר להגיע לביצועים תחרותיים מול מודלים שכוונו ב-RLHF יקר, תוך שימוש ב-DPO על מודל-בסיס קטן יחסית ותקציב-חישוב מוגבל — הדגמה מוקדמת ומשפיעה ליכולת המעשית של השיטה. מאז, גרסאות משופרות נוספות פותחו כדי לטפל בחסרונות ספציפיים שהתגלו בשיטה המקורית — כמו אופטימיזציית-זהות-העדפה (IPO — Identity Preference Optimization), שמוסיפה רגולריזציה כדי לצמצם התאמת-יתר לנתונים רועשים, וכמו אופטימיזציית כהנמן-טברסקי (KTO — Kahneman-Tversky Optimization), שמסתפקת במשוב בינארי פשוט (חיובי או שלילי) במקום זוגות-העדפה מפורשים.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות