HumanEval — אמת-מידה לתכנות; בעיותיה נכתבו ידנית כדי שלא יופיעו באימון
הגדרה
HumanEval היא אמת-המידה הסטנדרטית מ-2021 ל-164 בעיות-תכנות בפייתון; Codex פתר 28.8% מהן ביולי 2021, ו-GPT-4o הגיע ל-90.2% במאי 2024, לפי OpenAI.
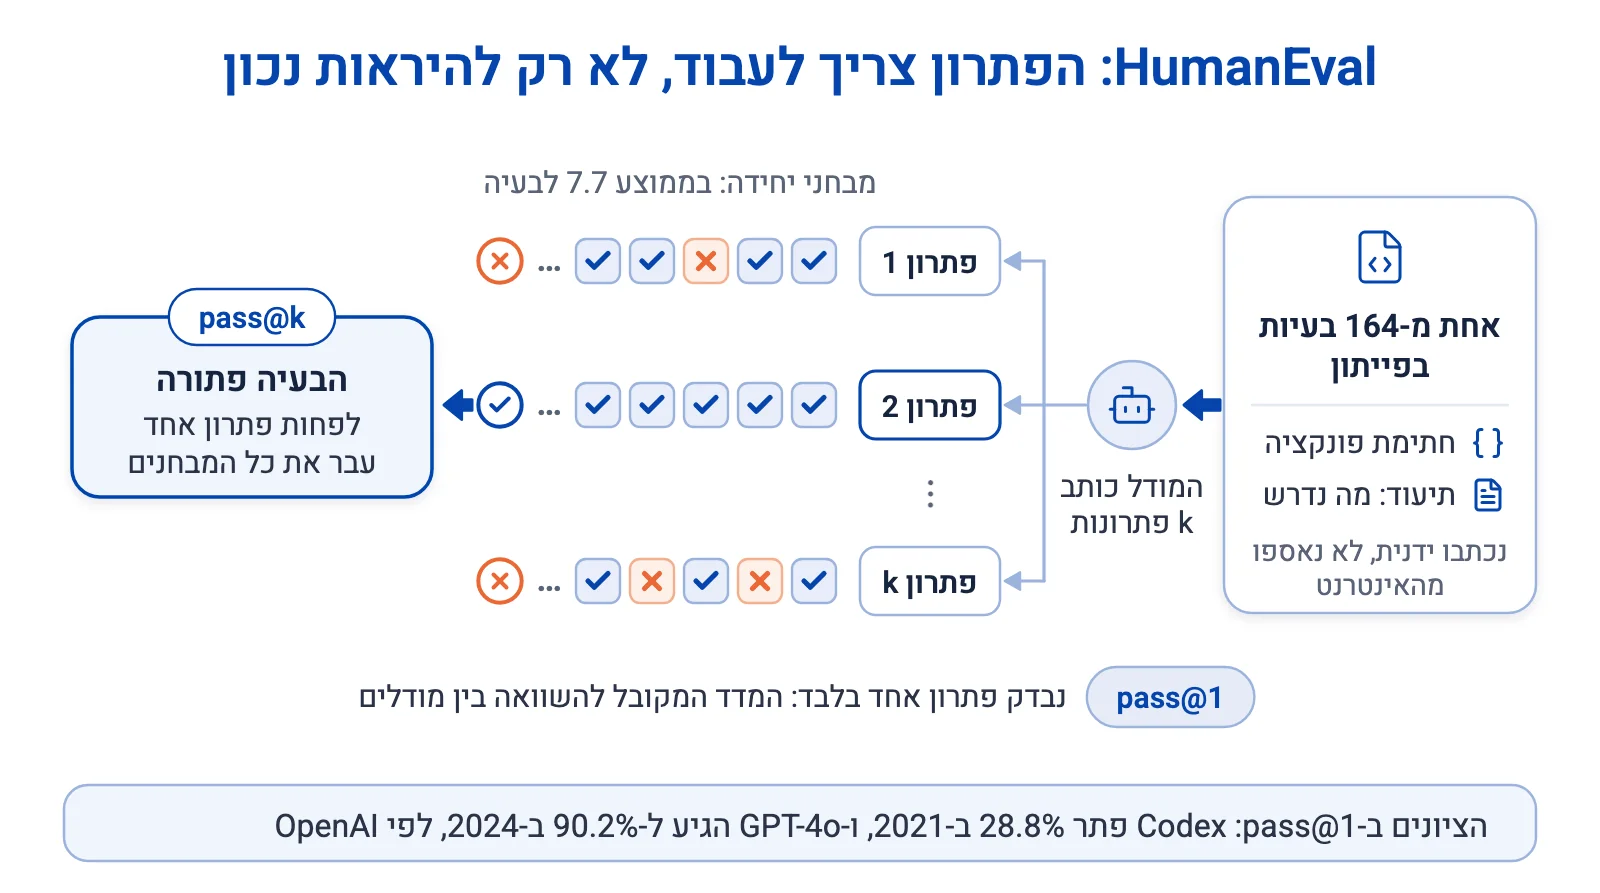
164 בעיות-תכנות שנועדו לבחון הבנה, לא שינון
HumanEval היא אמת-מידה שהציגה OpenAI ביולי 2021 יחד עם מודל Codex, גרסה מותאמת-לתכנות של GPT-3 שהפכה מאוחר יותר למנוע של GitHub Copilot. המבחן מורכב מ-164 בעיות-תכנות בפייתון שנכתבו ידנית — לא נאספו מהאינטרנט — כדי לוודא שאף פתרון שלהן לא הופיע כבר בנתוני-האימון של מודל כלשהו. כל בעיה כוללת חתימת-פונקציה, תיעוד-טקסט (docstring) שמתאר מה נדרש, ובממוצע 7.7 מבחני-יחידה שבודקים אם הפתרון שהמודל כתב באמת עובד — לא רק נראה נכון.
המדד: pass@k
הציון נמדד ביחידה שנקראת pass@k: המודל מייצר k פתרונות שונים לאותה בעיה, והבעיה נחשבת "פתורה" אם לפחות אחד מהם עובר את כל מבחני-היחידה. pass@1, שבו נבדק פתרון בודד בלבד, הוא המדד המקובל ביותר להשוואה בין מודלים, ובו משתמשים כמעט כל המספרים בערך הזה.
מ-Codex ועד GPT-4o: הקפיצה בפייתון
במאמר המקורי מיולי 2021 פתר Codex — בגרסתו שנבדקה — 28.8 אחוזים מ-164 הבעיות ב-pass@1, לעומת 0 אחוזים ל-GPT-3 הרגיל (שלא אומן על קוד) ו-11.4 אחוזים ל-GPT-J. ב-14 במרץ 2023, כשנה וחצי אחר-כך, שחררה OpenAI את GPT-4, ולפי הדוח הטכני הרשמי שלה הוא הגיע ל-67.0 אחוזים — יותר מכפול מהניקוד של Codex. ב-13 במאי 2024 הציגה OpenAI את GPT-4o, שלפי דיווחי החברה הגיע ל-90.2 אחוזים.
מספר שתלוי בשיטת-הבדיקה
מחקר עצמאי בשם EvalPlus, שהוצג ב-NeurIPS 2023, בדק את אותו GPT-4 מול רתמת-בדיקה שלו-עצמו והגיע לציון-בסיס גבוה בהרבה — כ-88 אחוזים — לעומת ה-67.0 הרשמיים שדיווחה OpenAI. הפער אינו סתירה במובן של טעות, אלא תוצאה של הבדלים בגרסת-המודל שנבדקה, בשיטת ניקוי-הפלט ובאופן שבו נספרות תשובות גבוליות. EvalPlus גם הרחיב את מבחני-היחידה של HumanEval פי 80 ומצא ש-HumanEval+ המחמיר יותר מוריד ציוני pass@k של מודלים שונים בעד 19.3 עד 28.9 אחוזים — סימן לכך שהמבחן המקורי החמיץ קוד שגוי שבמקרה עבר את הבדיקות המצומצמות שלו.
ההבדל מהמושג הכללי "אמת-מידה"
HumanEval הוא מופע ספציפי ומתוארך של המושג הכללי "אמת-מידה" (Benchmark), ממוקד בתחום צר אחד — כתיבת-קוד בפייתון — בניגוד למבחני-ידע רב-תחומיים כמו MMLU. הערך הזה עוסק במסלול-הציונים ההיסטורי של HumanEval עצמו ובמה שהוא מודד בפועל, ולא בבעיות הכלליות של אמות-מידה כשיטת-מדידה — לכך מוקדש הערך הנפרד באתר.
ההשפעה מעבר לציון: GitHub Copilot
מעבר לתפקידו כאמת-מידה, HumanEval נולד מאותו מודל (Codex) שהפעיל את הגרסה המסחרית הראשונה של GitHub Copilot, שיצאה כתצוגה-מקדימה ביוני 2021 — חודש לפני שהמאמר שהציג את HumanEval עצמו התפרסם. כלומר אותו מחקר שיצר את מבחן-ההשוואה יצר גם את המוצר המסחרי הראשון בקנה-מידה תעשייתי שנמדד באמצעותו. הקשר הזה הוא הסיבה שהתוצאות על HumanEval ממשיכות להיחשב לאינדיקציה הישירה ביותר ליכולת-תכנות מעשית של מודל, לא רק לציון תחרותי.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
| ציון (pass@1) | הערה | |
|---|---|---|
| Codex (יולי 2021) | 28.8% | המאמר המקורי שהציג את HumanEval |
| GPT-3 (יולי 2021, ללא אימון-קוד ייעודי) | 0% | לשם השוואה, מאותו מאמר |
| GPT-J (יולי 2021) | 11.4% | לשם השוואה, מאותו מאמר |
| GPT-4 (מרץ 2023) | 67.0% | דוח טכני רשמי, OpenAI |
| GPT-4 (רתמת-בדיקה של EvalPlus, 2023) | כ-88% | מחקר עצמאי, שיטה מחמירה יותר |
| GPT-4o (מאי 2024) | 90.2% | לפי OpenAI |
שאלות נפוצות ❓
כמה בעיות יש ב-HumanEval, ומה סוג הבעיות?
164 בעיות-תכנות בפייתון, כתובות-ידנית (לא נאספו מהאינטרנט), כל אחת עם חתימת-פונקציה, תיעוד-טקסט ובממוצע 7.7 מבחני-יחידה שבודקים אם הפתרון באמת עובד.
מה זה pass@1, וכמה השתפרו בו מודלים לאורך זמן?
pass@1 בודק אם פתרון-קוד בודד שהמודל ייצר עובר את כל מבחני-היחידה של הבעיה. Codex, שהציג את המבחן ביולי 2021, פתר 28.8 אחוזים; GPT-4 הגיע ל-67.0 אחוזים במרץ 2023; GPT-4o הגיע ל-90.2 אחוזים במאי 2024.
למה יש פער בין ציון GPT-4 הרשמי ל-HumanEval לציון שמצא מחקר EvalPlus?
OpenAI דיווחה על 67.0 אחוזים ב-2023; מחקר EvalPlus, שהוצג ב-NeurIPS 2023, בדק את אותו מודל ברתמת-בדיקה שונה והגיע לכ-88 אחוזים. הפער נובע מהבדלים בגרסת-המודל ובשיטת-הבדיקה, לא מטעות.
מה הקשר בין HumanEval ל-GitHub Copilot?
שניהם נולדו מאותו מודל, Codex של OpenAI: Copilot יצא כתצוגה-מקדימה ביוני 2021, ו-HumanEval פורסם חודש לאחר מכן, ביולי 2021, כאמת-המידה שמדדה את אותו מודל.
מה ההבדל בין HumanEval ל-HumanEval+?
HumanEval+, שפיתח מחקר EvalPlus, מרחיב את מבחני-היחידה של HumanEval המקורי פי כ-80 — ומוצא שהגרסה המחמירה מורידה ציוני pass@k של מודלים שונים בעד 19.3 עד 28.9 אחוזים, כלומר המבחן המקורי החמיץ קוד שגוי.