LLM Model Routing (ניתוב מודלים)
הגדרה
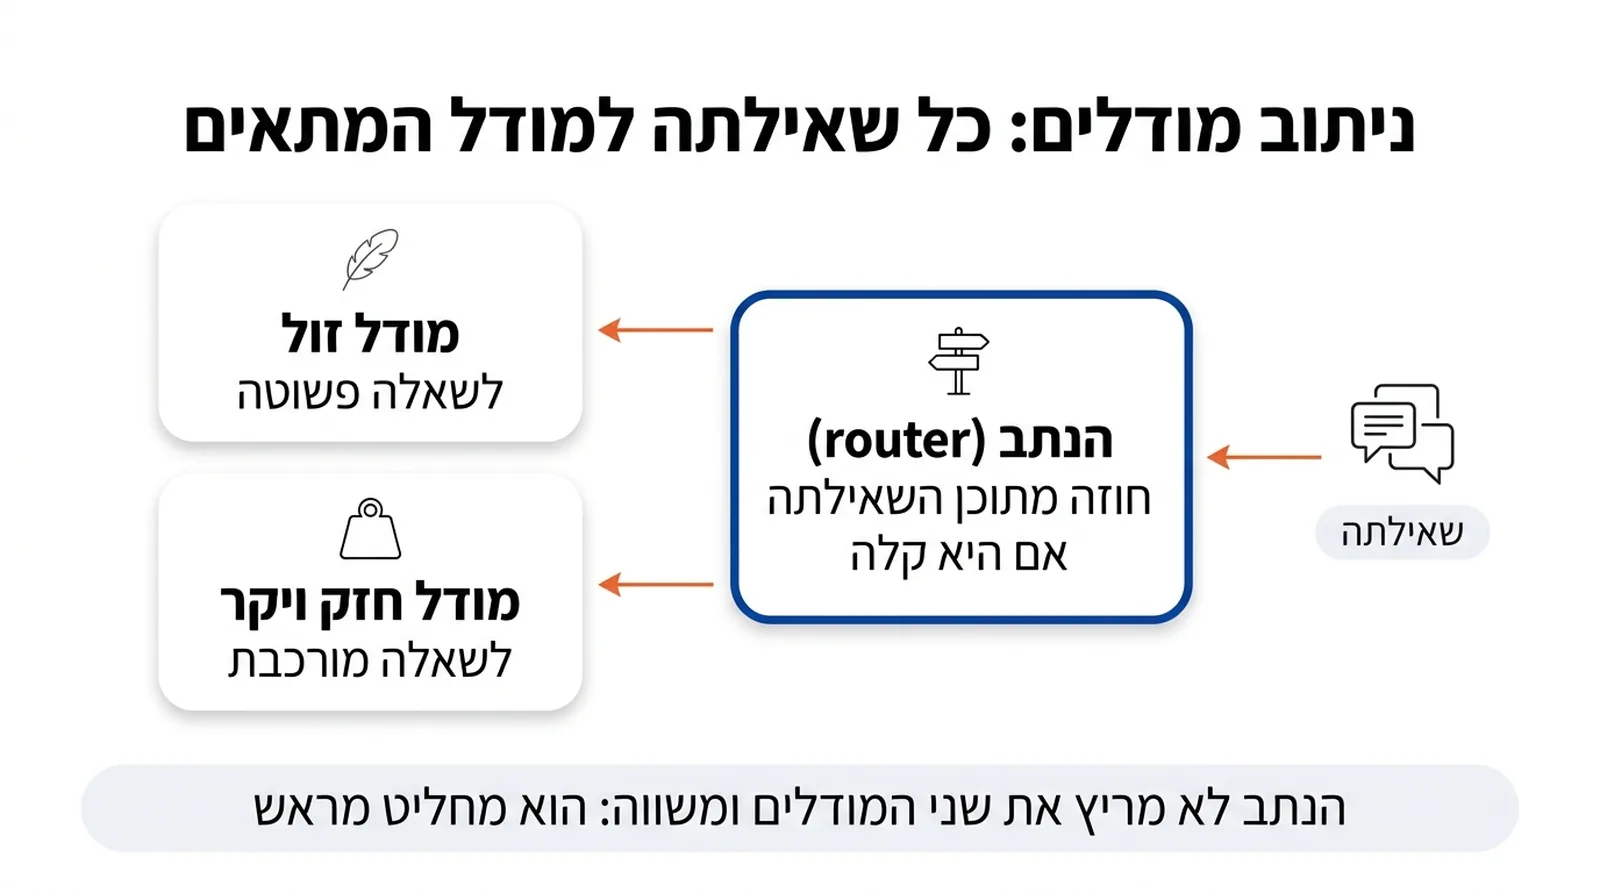
ניתוב מודלים הוא מנגנון שמחליט אוטומטית לאיזה מודל-AI לשלוח כל שאילתה — מודל זול לשאלה פשוטה, מודל חזק ויקר לשאלה מורכבת — כדי לחסוך בעלות בלי לפגוע באיכות.
מה זה ניתוב מודלים
ניתוב מודלים (LLM Model Routing) הוא מנגנון-תוכנה שבוחן כל שאילתה שמגיעה למערכת ומחליט, בזמן-אמת, לאיזה מודל-שפה לשלוח אותה — מודל חלש וזול כשמדובר בשאלה פשוטה, מודל חזק ויקר כשמדובר במשימה מורכבת. הרעיון מגיב לבעיה מוכרת: מודל שפה בודד, גם אם הוא החזק ביותר הזמין, מתומחר לפי אותו מחיר עבור כל שאילתה — כפי שמראה הערך תמחור-לפי-טוקן — גם כשהתשובה היא "מה השעה בטוקיו" ולא ניתוח-משפטי מורכב.
הבעיה שניתוב פותר
כשמערכת שולחת כל בקשה למודל החזק ביותר הזמין, היא משלמת מחיר-פרימיום גם עבור שאילתות שמודל קטן וזול יכול היה לפתור באותה איכות. הפער בין מודלים זולים ליקרים עשוי להגיע לפער-מחירים גדול מאוד למיליון-טוקנים, כפי שמתועד בערך תמחור-לפי-טוקן — כך שבחירת-מודל לא-מותאמת הופכת יקרה במיוחד באפליקציה שמריצה מיליוני בקשות ביום.
RouteLLM: דוגמה מוכרת
RouteLLM, מסגרת-קוד-פתוח שפותחה בקבוצת-המחקר LMSYS (UC Berkeley), היא אחת הדוגמאות המוכרות ביותר לניתוב-מודלים בפועל. לפי Zilliz, הראוטר מאומן על נתוני-העדפה מפלטפורמת Chatbot Arena, ובנוי משני רכיבים: "מודל-חיזוי-ניצחון" — הערכת-הסתברות שהמודל החזק יביס את המודל החלש בשאילתה נתונה — ו"סף-עלות" (cost threshold), פרמטר שקובע איזה חלק מהשאילתות בפועל מנותב למודל החזק ואיזה נשאר עם הזול. RouteLLM מספקת שרת תואם-OpenAI, כך שאפשר להטמיע אותה מול קוד קיים בלי לשנות את ממשק ה-API שהמוצר כבר משתמש בו.
התוצאות שנמדדו
לפי LMSYS, ניתוב שאילתות פשוטות למודל הקטן צמצם את עלות-ההסקה ביותר מ-85% על מבחן MT-Bench, תוך שמירה על כ-95% מאיכות-GPT-4; על מבחנים אחרים החיסכון היה נמוך יותר — כ-45% ב-MMLU וכ-35% ב-GSM8K — הבדל שממחיש שהחיסכון בפועל תלוי בסוג-המשימה ובמידת-הקלות של השאילתות שהניתוב מזהה בכל מבחן.
איך הניתוב מוחלט בפועל
בפועל, הראוטר אינו קורא לשני המודלים ומשווה את התשובות — הוא מייצר תחזית מוקדמת, על סמך תוכן-השאילתה בלבד, אם היא "קלה מספיק" למודל הזול. שאילתה שהראוטר מסמן כמורכבת מנותבת ישירות למודל החזק; כל השאר מקבל את המודל הזול. הדיוק של התחזית הזו הוא בדיוק מה שקובע אם החיסכון-הפוטנציאלי מתממש בלי לפגוע באיכות-בפועל.
מה זה אומר להחלטת רכש וארכיטקטורה
ניתוב מודלים נראה כמו החלטה הנדסית, אבל מבחינת עסק שמפעיל AI בקנה-מידה זו בראש-ובראשונה שאלה של עלות: אפליקציה שמריצה בקשות רבות יכולה לחסוך סכום משמעותי רק על ידי הפרדת שאילתות קלות מקשות, בלי לפגוע בחוויית-המשתמש. זו הסיבה שהוא מופיע לצד גישות אחרות לניהול-עלות-AI כמו כלכלת-יחידה של AI ו-FinOps ל-AI — כל אחת מזווית שונה על אותה בעיה. ארגונים יכולים גם להשתמש ב"שער" (Gateway) מוכן במקום לבנות את כל שכבת-הניתוב בעצמם. דוגמה בקוד פתוח היא LiteLLM של חברת BerriAI: ספרייה ושער-API שמציעים ממשק אחיד, בפורמט של OpenAI, למודלים ולשירותים ממגוון ספקים — בהם OpenAI, Anthropic, Google, Amazon Bedrock ו-Azure — וכך אפשר לצמצם את השינויים בקוד בעת החלפת מודל או ספק. מעבר לניתוב, השער מטפל גם בחלוקת עומסים, במעבר אוטומטי לספק חלופי ובמעקב אחר הוצאות; נכון לאוקטובר 2026, התיעוד מסמן את הניתוב האוטומטי לפי מורכבות הבקשה כתכונה בגרסת בטא. לרכיב שיושב במרכז המערכת יש גם מחיר אבטחתי: במרץ 2026 הופצו דרך מאגר-החבילות PyPI שתי גרסאות נגועות של LiteLLM, במסגרת מתקפת שרשרת-אספקה שנועדה לגנוב מפתחות-גישה, וחברת Mercor הודיעה שנפגעה ממנה.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
| MT-Bench | MMLU | GSM8K | |
|---|---|---|---|
| חיסכון בעלות-הסקה | מעל 85% | כ-45% | כ-35% |
שאלות נפוצות ❓
מה ההבדל בין ניתוב מודלים לתמחור-לפי-שימוש?
תמחור-לפי-שימוש (כמו תמחור-לפי-טוקן) קובע כמה עולה כל שאילתה אצל ספק נתון. ניתוב מודלים הוא מנגנון שקובע לאיזה מודל לשלוח כל שאילתה מלכתחילה — כלי לצמצום העלות שנוצרת מאותו תמחור, לא תחליף לו.
מי מחליט אם שאילתה "קלה" או "קשה"?
הראוטר עצמו — מודל קטן שאומן על נתוני-העדפה (ב-RouteLLM, מ-Chatbot Arena) לחזות מראש אם השאילתה זקוקה למודל החזק. ההחלטה מתקבלת לפני שליחת השאילתה לאף מודל-תשובה.
האם ניתוב פוגע באיכות התשובות?
לפי הנתונים של LMSYS, לא באופן משמעותי: על מבחן MT-Bench הניתוב שמר על כ-95% מאיכות-GPT-4 תוך חיסכון של מעל 85% בעלות. שיעור החיסכון והשמירה-על-איכות משתנים בין מבחנים שונים.
האם צריך לבנות ניתוב מאפס?
לא בהכרח. RouteLLM היא מסגרת-קוד-פתוח עם שרת תואם-OpenAI, כך שאפשר להטמיע אותה מול קוד קיים בלי לשנות את ממשק ה-API הקיים.
איך ניתוב מודלים קשור לניהול-עלות-AI רחב יותר?
הוא כלי אחד מתוך ארגז-כלים רחב יותר — לצד תמחור-לפי-טוקן, כלכלת-יחידה של AI ו-FinOps ל-AI — שכולם עוסקים באותה שאלה מזוויות שונות: כמה עולה AI בפועל ואיך שולטים בעלות הזו.