טבעות-קנוניה בביקורת-עמיתים
הגדרה
קבוצת-חוקרים המתאמת ביניהם — בדרך-כלל דרך הצעות-הדדיות (bidding) על מאמרים — כדי להיות מוקצית לביקורת מאמרי-חבריה ולקבל בתמורה חוות-דעת מוטות-לטובה, תוך עקיפת מנגנוני-ההקצאה האוטומטיים של כנסי-AI.
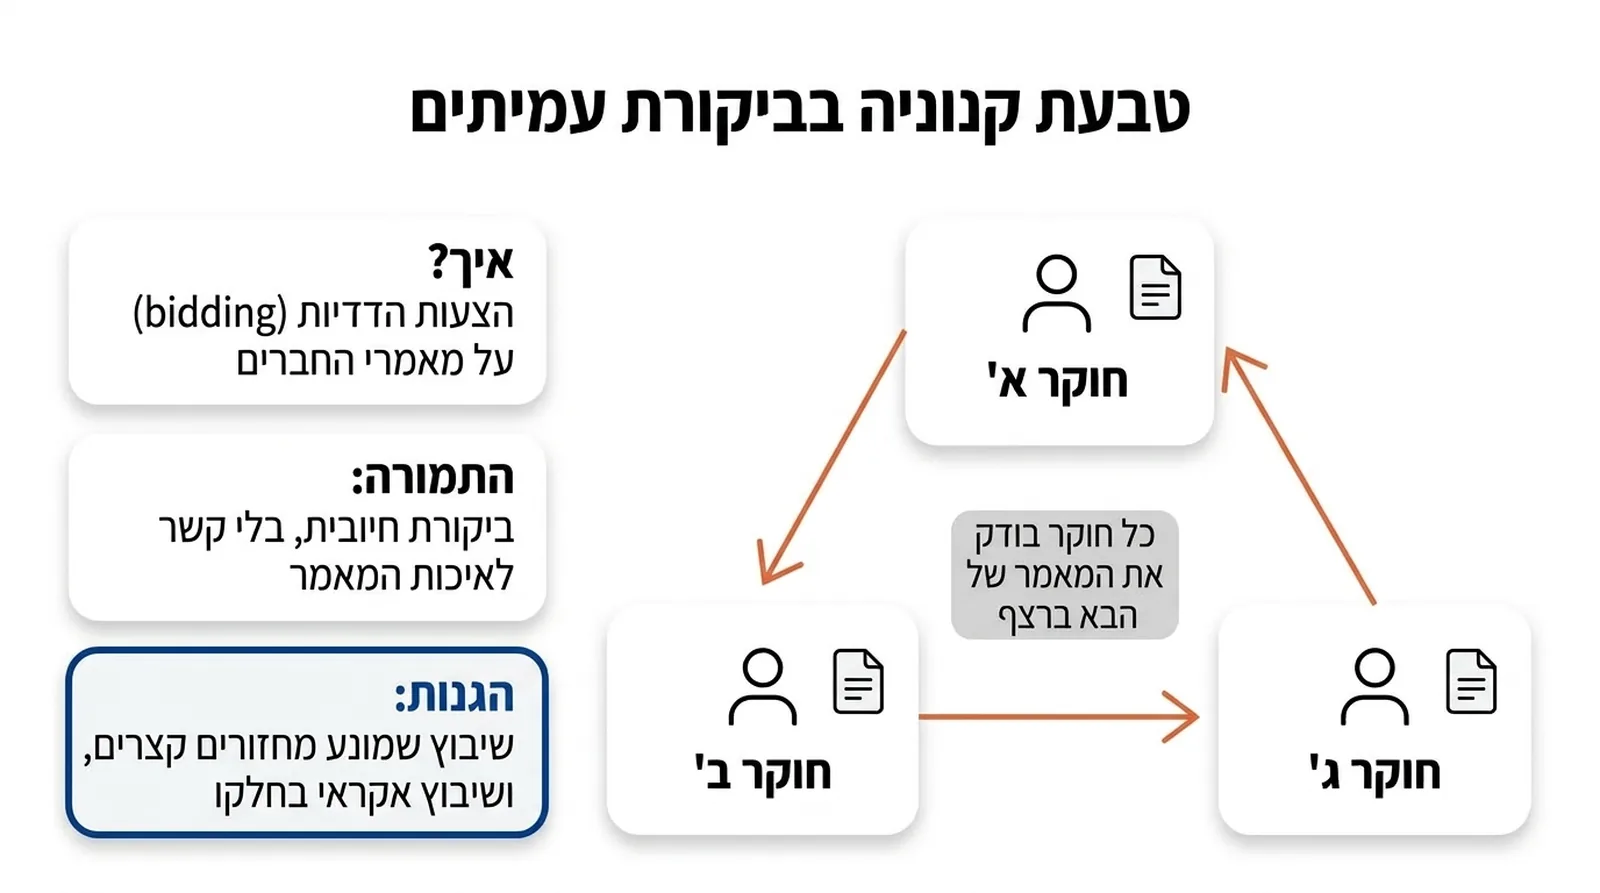
מהי טבעת-קנוניה, ואיך היא עוקפת את מנגנון-ההקצאה
כנסי-AI גדולים מקצים בודקים למאמרים באמצעות מערכת אוטומטית, שמשלבת שני מקורות-מידע: הצעות-הדדיות (bidding) שבהן בודקים מסמנים אילו מאמרים הם מעוניינים או אינם מעוניינים לבדוק, ודמיון-טקסטואלי בין המאמר המוגש לפרסומים קודמים של הבודק (המחושב באמצעות מודל-הטמעה בשם SPECTER, המשמש היום ב-NeurIPS, ICML, ICLR וב-TMLR). טבעת-קנוניה היא קבוצת-חוקרים שמתאמת מראש: כל חבר בקבוצה מגיש הצעה-הדדית חיובית על מאמרי חבריו כדי להגדיל את הסיכוי שהוא-עצמו יוקצה לבדוק אותם, ואז מעניק חוות-דעת חיובית ללא-קשר לאיכות המאמר בפועל — בעוד שהחבר האחר עושה בדיוק אותו הדבר בכיוון ההפוך.
שיטת-התקפה חדשה: הטעיית-דמיון-הטקסט, לא רק ההצעות
מחקר מ-2024 (שהוצג גם בכנס USENIX Security 2025, מאת ג'יה-יי הסייה, אדיטי רגוּנאתן וניהאר שאה) הראה שההגנות הקיימות נגד קנוניה התמקדו כמעט כולן בזיהוי הצעות-הדדיות חשודות, בהנחה שרכיב-דמיון-הטקסט של המערכת בטוח מפני מניפולציה. החוקרים הראו שההנחה הזאת שגויה: גם בלי לשלוח שום הצעה-הדדית, מחברים ובודקים מתואמים יכולים לנסח מחדש חלקים ממאמר כך שדמיון-הטקסט מול פרסומי-הבודק יזנק מלאכותית — במקרה-מבחן על נתוני NeurIPS 2023, ההתקפה העלתה את דירוג-הדמיון של בודק מתואם ממקום 101 ברשימת-המועמדים אל חמשת-המועמדים המובילים ב-92% מהמקרים. אפילו בלי לשנות מילה במאמר עצמו, בחירה קפדנית של הבודק אילו מפרסומיו-שלו לכלול בפרופיל שלו — במיוחד צמצום לפרסום בודד, הדומה ביותר למאמר הנבדק — הספיקה כדי לבצע את אותה קפיצה, ממקום 101 לחמישיית-המועמדים המובילים, ב-41% מהמקרים.
עד כמה התופעה שכיחה בפועל
קשה לאמוד את היקף-התופעה בפועל: קנוניה מוצלחת נראית מבחוץ כמו התאמה טבעית בין בודק למאמר, ולכן רוב הידע עליה מגיע ממקרים שנחשפו ומניסויים שמדגימים עד כמה קל לבצע אותה. אותו מחקר בדק שאלה נוספת: האם מי שמתכנן קנוניה יכול להסתמך על נתוני-השנה-הקודמת, הפומביים, כדי לחזות מראש את הצלחת-ההתקפה על השנה הנוכחית, שנתוניה עדיין סודיים. החוקרים מצאו מתאם-דרגות (Spearman) חזק — 0.62, 0.83, 0.92 ו-0.93, בארבע הגדרות-ניסוי שונות — בין הדירוגים המניפולטיביים שהניבה אותה שיטת-התקפה על נתוני NeurIPS 2022 (פומביים באותו זמן) לבין הדירוגים שהיא הניבה על נתוני NeurIPS 2023 (סודיים באותו זמן). המשמעות: תוקף פוטנציאלי לא צריך לנחש בעיוורון — הוא יכול לכייל את ההתקפה מראש על נתוני שנה ישנה ולסמוך שהיא תעבוד גם על השנה הנוכחית.
התשובה המוסדית הראשונה: מגבלות-שיבוץ ב-AAAI-2021
הבעיה זכתה לתשומת-לב רחבה בזכות מאמר של מייקל ל. ליטמן (Michael L. Littman) ב-Communications of the ACM (כרך 64, גיליון 6, 2021), שתיאר 'טבעות-קנוניה' כך: קבוצות-מחברים שבודקות ותומכות זו-בזו תוך הפרת אנונימיות והסתרת ניגודי-עניינים. מחקר אקדמי שפרסם בעקבותיו ניסוח מתמטי-מדויק יותר של הבעיה (Boehmer, Bredereck ו-Nichterlein, הוצג בכנס AAAI 2022) הגדיר טבעת-קנוניה כרצף-בודקים שבו כל בודק בודק מאמר של הבודק הבא ברצף, כשהאחרון בשרשרת בודק את מאמרו של הראשון — כך שכל מאמר בשרשרת מקבל סיכוי-קבלה גבוה בלי קשר לאיכותו המדעית. עוד לפני שמחקר-ההמשך הזה התפרסם, כנס AAAI כבר נדרש לבעיה: לפי הרצאת-הפתיחה של יושבי-ראש הכנס במהדורת 2021 (Kevin Leyton-Brown ו-Mausam), מנגנון-שיבוץ-הבודקים באותה שנה כלל אילוץ-רך שנועד למנוע רצפי-ביקורת קצרים — מחזורים של עד שני בודקים. גישה משלימה הוצגה עוד קודם לכן, בכנס NeurIPS 2020 (סטיבן ג'קמן, ניהאר שאה ועמיתיהם): שיבוץ אקראי-בחלקו, שמגביל מראש את ההסתברות שבודק מסוים ישובץ למאמר מסוים — ובניסויים על נתונים מכנסים קודמים הגביל ל-50% את הסיכוי של בודק זדוני להגיע למאמר שהוא מכוון אליו, תוך שמירה על יותר מ-90% מאיכות-ההתאמה האופטימלית.
כמה בודקים באמת נמצאים בסיכון, ומה מחיר התיקון
אותו מחקר-המשך משנת 2022 בדק כמה נפוצים מחזורי-ביקורת כאלה גם בשיבוץ 'אופטימלי' רגיל, שלא נועד במיוחד למנוע אותם: בניסוי על נתונים אמיתיים מכנס ICLR 2018 (שבו כל המחברים שימשו גם כבודקים), במדגם של 150 מאמרים, 40% מהבודקים נמצאו בתוך מחזור-ביקורת של עד שני בודקים, 58% בתוך מחזור של עד שלושה, ו-76% בתוך מחזור של עד ארבעה; גם במדגם גדול בהרבה, של 900 מאמרים, עדיין 32%, 41% ו-55% (בהתאמה) מהבודקים נמצאו במחזורים מקבילים. המחקר גם מצא שהמחיר של מניעת מחזורים כאלה נמוך להפתיע: השיבוץ האופטימלי שאינו כולל אף מחזור-של-שני-בודקים פוגע במשקל-האיכותי הכולל של השיבוץ ב-0.8% לכל היותר בממוצע, ואלגוריתם-היוריסטי מהיר שפיתחו החוקרים מצא שיבוץ ללא מחזורים קצרים בפחות מ-30 שניות, במחיר-איכות ממוצע של 3.1 עד 3.3 אחוזים. הבעיה, במילים אחרות, לא נפתרה סופית ב-2021 — אבל התברר שהיא גם זולה יחסית לתקן. ההגנות ממשיכות להתפתח: לקראת AAAI-26 דיווחו מארגני הכנס, בעדכון רשמי על תהליך-הביקורת, שמנגנון-השיבוץ שלהם כולל בדיקות-עמידות מפני מניפולציה בהצעות, כך ש'הצעות-הדדיות לא-מורשות' משפיעות עליו מעט מאוד, ושניסוי-הביקורת בסיוע-AI שערכו כלל גם כלים לאיתור קנוניה בין בודקים ולנטרולה.
למה זה חמור יותר מ'סתם' ביקורת רשלנית
ביקורת-עמיתים רשלנית או שגויה היא כשל אנושי מוכר; קנוניה היא משהו אחר — עקיפה מכוונת של המנגנון שאמור להבטיח שהערכת-מאמר תבוא מגורם בלתי-תלוי. כשקבוצת-חוקרים מצליחה להבטיח לעצמה ביקורת-הדדית-חיובית, התוצאה היא לא רק מאמר בודד שמתקבל שלא-בצדק, אלא שחיקה של עצם ההנחה שקבלה לכנס-דגל משקפת שיפוט חיצוני-אמיתי — אותה הנחה שמשבר-העומס בביקורת-העמיתים כבר מראה שנשחקת ממילא בגלל היקף-ההגשות.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
שאלות נפוצות ❓
מה זה בדיוק 'טבעת-קנוניה' בביקורת-עמיתים?
קבוצת-חוקרים שמתאמת מראש — למשל דרך הצעות-הדדיות (bidding) — כדי שכל חבר יוקצה לבדוק את מאמרי-חברי-הקבוצה, ואז מעניק חוות-דעת חיובית ללא-תלות באיכות המאמר בפועל. הבעיה זכתה לתשומת-לב רחבה בזכות מאמר של מייקל ליטמן ב-Communications of the ACM ב-2021.
איך אפשר לעקוף את מנגנון-ההקצאה בלי לשלוח הצעות-הדדיות מוצהרות?
מחקר מ-2024 הראה שאפשר לנסח מחדש חלקים ממאמר כך שדמיון-הטקסט מול פרסומי-הבודק (הנמדד באמצעות מודל SPECTER) יזנק מלאכותית — במקרה-מבחן על נתוני NeurIPS 2023 זה העלה בודק מתואם ממקום 101 לחמישיית-המועמדים המובילים ב-92% מהמקרים, וגם רק בחירה קפדנית של פרסומי-עבר, בלי לגעת במאמר כלל, הספיקה ב-41% מהמקרים.
יש הוכחה שקנוניה קורית בפועל, לא רק בתאוריה?
קשה למדוד ישירות, כי קנוניה מוצלחת נראית מבחוץ כמו התאמה טבעית. אבל מחקר על שיבוצי-בודקים 'אופטימליים' רגילים, על נתוני כנס ICLR 2018, מצא ש-40% מהבודקים (במדגם של 150 מאמרים) ו-32% (במדגם של 900 מאמרים) נמצאים בתוך מחזור-ביקורת של שני בודקים שמאפשר קנוניה, גם כשאיש לא תכנן זאת — מה שמראה כמה רחבה ההזדמנות למי שכן רוצה לנצל אותה.
מה עשה AAAI-2021 כדי להתמודד עם זה?
מנגנון-השיבוץ שלו כלל אילוץ-רך שמנע רצפי-ביקורת קצרים — מחזורים של עד שני בודקים שבהם כל אחד בודק את מאמר האחר. מחקר מאוחר יותר הראה שאילוץ כזה עולה בממוצע פחות מ-0.8% מאיכות-השיבוץ הכוללת.
זה קשור למשבר-העומס בביקורת-העמיתים בכנסי-AI?
כן — ככל שכנסים גדלים ומספר-הבודקים לא גדל באותו קצב, קשה יותר לזהות דפוסי-קנוניה חריגים בזרם עצום של הצעות ודירוגים, מה שהופך את הבעיה לרלוונטית עוד יותר ככל שהכנסים גדלים.