כוונון-עדין חסכוני (PEFT)
הגדרה
PEFT הוא שם-כולל למשפחת שיטות שמכווננות מודל גדול תוך עדכון חלק קטן בלבד מהפרמטרים שלו — LoRA היא הדוגמה הפופולרית ביותר בקטגוריה הזו.
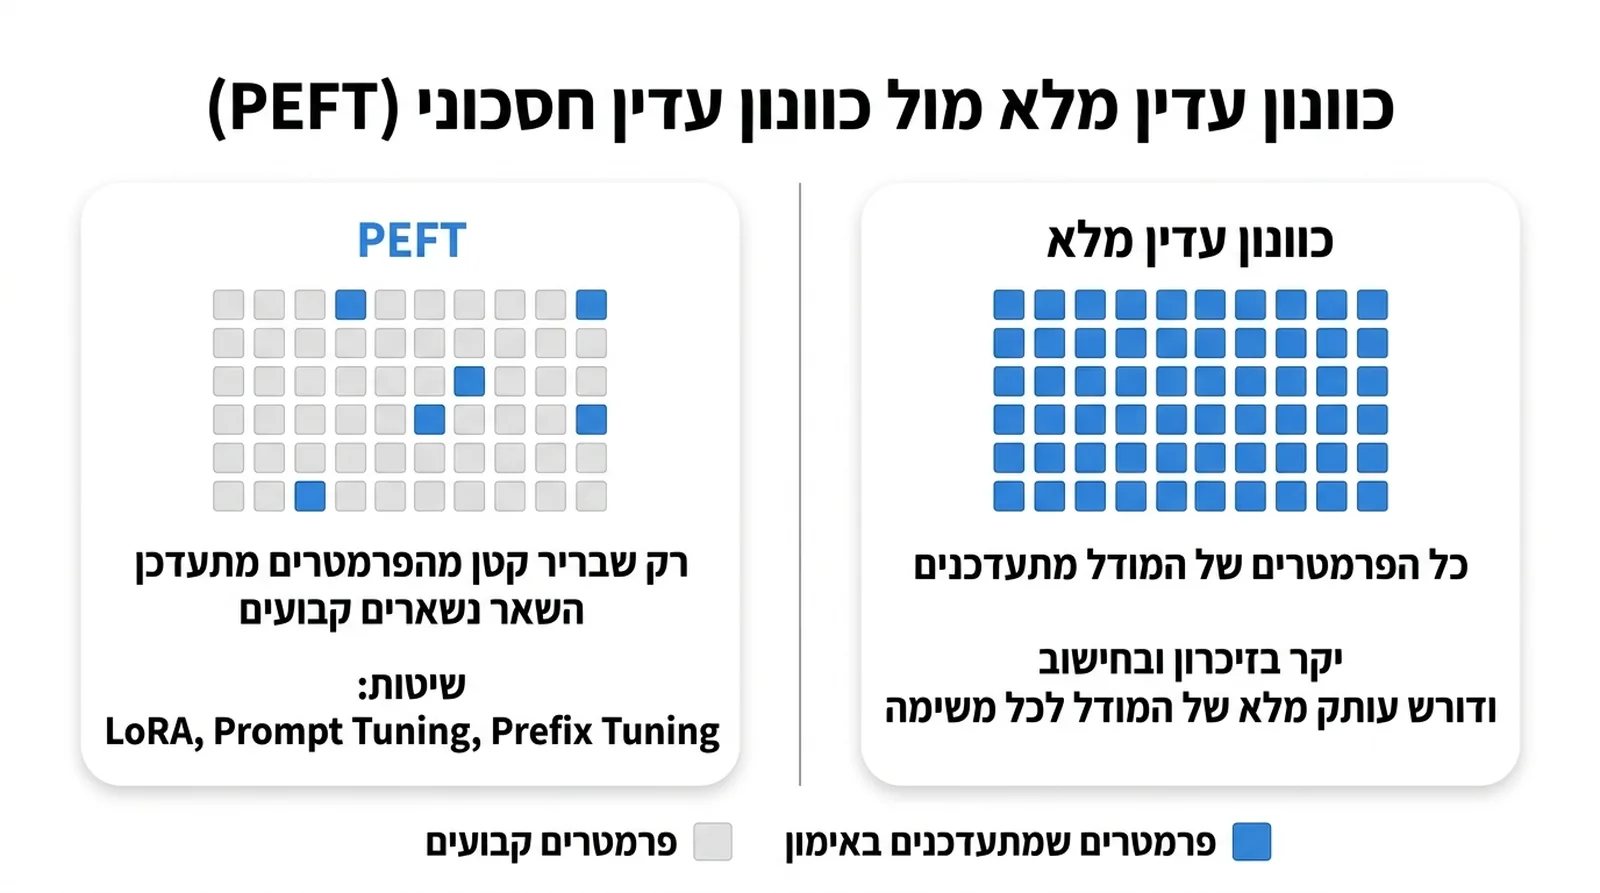
כוונון-עדין "מלא" (עדכון כל הפרמטרים) יקר בזיכרון ובחישוב, ודורש לשמור עותק שלם נפרד של המודל לכל משימה. כוונון-עדין חסכוני (PEFT — Parameter-Efficient Fine-Tuning) מציע אלטרנטיבות שמעדכנות רק שבריר קטן מהפרמטרים, ומשאירות את השאר קבוע.
מעבר להתאמה-נמוכת-דרגה (LoRA), המשפחה כוללת שיטות נוספות — כמו Prompt Tuning — שהתפתחו במקביל מ-2019 ואילך, וכולן חולקות אותו רעיון בסיסי: להשיג רוב היתרון של כוונון-עדין מלא, במחיר-חישוב ואחסון קטן בהרבה. טכניקה נוספת במשפחה, Prefix Tuning (גם היא מ-2021), מוסיפה לכל קלט "קידומת" וירטואלית מאומנת — במקום לשנות משקלים פנימיים כלשהם, המודל "רואה" תוספת קטנה של הקשר-מאומן בתחילת כל קלט, ולומד להתאים את התנהגותו בהתאם, בלי לגעת כלל בפרמטרים המקוריים.
ספריית peft של Hugging Face, שהושקה ב-2022, הפכה למעשה לתשתית-הסטנדרט לגישות האלה — היא מוסיפה תמיכה בכוונון-חסכוני לכמעט כל מודל בעל-משקלים-פתוחים בכמה שורות קוד בלבד. הדבר שינה משמעותית את מי שיכול בפועל לכוונן מודל-שפה גדול: מניסיון שהיה נחלת חברות-ענק בעלות משאבי-חישוב עצומים, לעניין נגיש גם לחוקר בודד עם כרטיס-מסך צרכני יחיד.
נכון ל-2026, ספריות קוד-פתוח ייעודיות הפכו שיטות כאלה לזמינות בכמה שורות קוד בלבד, מה שהוריד משמעותית את סף-הכניסה לכוונון מודלים גדולים גם לצוותים ומפתחים קטנים, לא רק לחברות-ענק — שינוי שהאיץ באופן ניכר את קצב-הפיתוח של כלי AI ייעודיים בקהילת הקוד-הפתוח. ההבדל המעשי בין שיטות-PEFT השונות הוא בעיקר בפשרה בין פשטות-שימוש, ביצועים, וגמישות — ולכן נפוץ לראות מפתחים בוחנים כמה שיטות במקביל לפני שהם מחליטים איזו מתאימה למשימה הספציפית שלהם. דוגמה מוחשית: חוקר יחיד עם כרטיס-מסך ביתי יכול היום לכוונן גרסה ייעודית של מודל-שפה גדול תוך שעות ספורות ובעלות זניחה יחסית — משימה שלפני 2022 הייתה בפועל בלתי-אפשרית בלי גישה לתשתית-ענן יקרה של חברה גדולה.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות