שקיפות (Transparency)
הגדרה
שקיפות (Transparency) היא עד כמה ברור למשתמש איך ולמה מודל AI הגיע לתשובה מסוימת.
מה זו שקיפות ב-AI, ולמה מודלים הם 'קופסה שחורה'
שקיפות (Transparency) בהקשר של AI מתייחסת לעד כמה ברור למשתמש — או אפילו למפתח עצמו — איך ולמה מודל הגיע לתשובה או להחלטה מסוימת. רוב מודלי AI המתקדמים היום, ובפרט מודלי שפה גדולים המבוססים על רשתות נוירונים עמוקות, פועלים כ"קופסה שחורה": גם היוצרים שלהם לא יכולים תמיד להסביר במדויק מדוע המודל בחר תשובה ספציפית אחת ולא אחרת, כי ההחלטה מתפזרת על פני מיליארדי פרמטרים ולא נשמרת בשום מקום כ"סיבה" קריאה.
Explainable AI: SHAP ו-LIME
תחום מחקר שלם, "בינה מלאכותית מוסברת" (Explainable AI), מנסה לפתוח את הקופסה השחורה הזו בפועל. שתי טכניקות נפוצות במיוחד: SHAP (ראשי-תיבות של SHapley Additive exPlanations) ו-LIME (ראשי-תיבות של Local Interpretable Model-agnostic Explanations) — שיטות שמחשבות, אחרי שהמודל כבר החליט, אילו מהמאפיינים בקלט השפיעו הכי הרבה על התוצאה, ומציגות זאת כציון-חשיבות לכל מאפיין. שיטות כאלה לא "פותחות" את המודל עצמו, אלא מנסות לשחזר הסבר סביר בדיעבד — הבחנה חשובה בין "פרשנות אמיתית" (Interpretability, איך המודל בנוי ופועל מבפנים) ל"הסברתיות" (Explainability, איך הוא הגיע לתוצאה ספציפית) — שתי מילים שנשמעות קרובות אבל מתארות שאלות שונות. SHAP עצמה, שיטה שנוסחה במאמר-יסוד משנת 2017 מאת סקוט לונדברג וסו-אין לי מאוניברסיטת וושינגטון, מבוססת על מושג משחקים-שיתופיים בשם ערך-שאפלי — דרך מתמטית מוגדרת-היטב לחלק "קרדיט" בין שחקנים (כאן: מאפייני-קלט) שתרמו יחד לתוצאה משותפת.
מקרה מזהיר: המסווג שלמד לזהות תגית, לא סוס
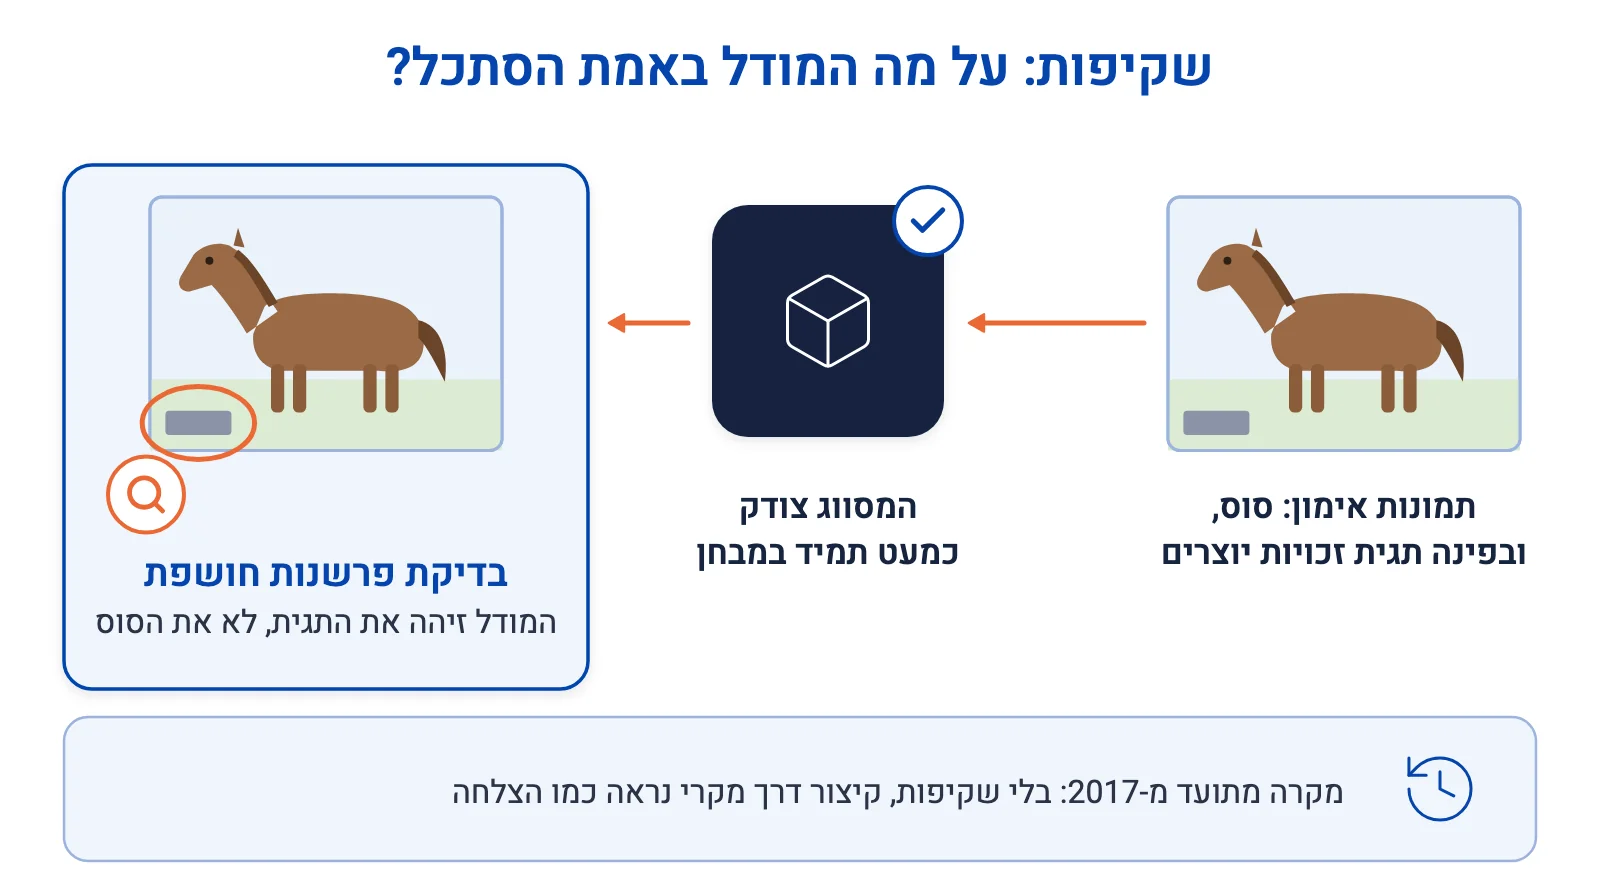
המחיר הידוע-פחות של חוסר-שקיפות מודגם במקרה מתועד מ-2017: מסווג-תמונות שאומן לזהות סוסים התברר כמזהה בפועל תגית-זכויות-יוצרים שהופיעה בפינת רוב תמונות-הסוסים במאגר-האימון — לא את הסוס עצמו. המודל "צדק" כמעט תמיד במבחן, בלי שאף אחד הבין למה, עד שבדיקת-פרשנות חשפה את הקיצור-הדרך המקרי הזה.
GDPR ו'הזכות להסבר' (2018)
שקיפות הפכה גם לדרישה משפטית, לא רק אתגר טכני: תקנת-הפרטיות האירופית (GDPR — General Data Protection Regulation), בתוקף מאז 2018, מעניקה לאזרחים "זכות להסבר" על החלטות אלגוריתמיות שמשפיעות עליהם — צעד שהפך את השקיפות משיקול-מחקרי לחובה-רגולטורית ממשית.
EU AI Act 2024: מחובה-משפטית-תיאורטית לדרישת-ציות
חוק-הבינה-המלאכותית האירופי (EU AI Act), שנכנס לתוקף באוגוסט 2024, מרחיב את זה עוד: מערכות-AI "בסיכון-גבוה" יחויבו בתיעוד, הסבר-החלטות, ואפשרות-פנייה לבן-אדם — לא רק זכות תיאורטית על-הנייר, אלא דרישת-ציות עתידית עם סנקציות. חשוב לדייק: עיקר החובות האלה נדחו בפועל, בעקבות חבילת-הפישוט 'AI Omnibus' מיולי 2026, אל דצמבר 2027 ואוגוסט 2028 — כך שנכון-להיום הן עדיין לא דרישת-ציות פעילה, אלא מסגרת שנכנסת לתוקף בהדרגה.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
שאלות נפוצות ❓
למה קשה להסביר למה מודל AI בחר תשובה מסוימת?
כי מודלי AI מתקדמים, ובפרט רשתות נוירונים עמוקות, פועלים כ'קופסה שחורה': ההחלטה מתפזרת על פני מיליארדי פרמטרים ולא נשמרת בשום מקום כ'סיבה' קריאה — גם היוצרים לא תמיד יכולים להסביר במדויק מדוע נבחרה תשובה ספציפית אחת ולא אחרת.
מה ההבדל בין Interpretability ל-Explainability?
Interpretability (פרשנות אמיתית) עוסקת באיך המודל בנוי ופועל מבפנים; Explainability (הסברתיות) עוסקת באיך הוא הגיע לתוצאה ספציפית מסוימת. שיטות כמו SHAP ו-LIME מספקות הסברתיות בדיעבד, לא פרשנות אמיתית של פנים-המודל.
מה קרה במקרה מסווג-הסוסים?
ב-2017 התברר שמסווג-תמונות שאומן לזהות סוסים למד בפועל לזהות תגית-זכויות-יוצרים שהופיעה בפינת רוב תמונות-הסוסים במאגר-האימון, ולא את הסוס עצמו — והצליח כמעט תמיד במבחן בלי שאף אחד הבין למה, עד שבדיקת-פרשנות חשפה את הקיצור-דרך המקרי.
מה מחייב ה-EU AI Act ממערכות 'בסיכון-גבוה'?
חוק-הבינה-המלאכותית האירופי, שנכנס לתוקף באוגוסט 2024, מטיל על מערכות-AI בסיכון-גבוה חובות תיעוד, הסבר-החלטות ואפשרות-פנייה לבן-אדם, ומגבה אותן בסנקציות. אבל נכון-להיום הן עדיין אינן דרישת-ציות פעילה: חבילת-הפישוט AI Omnibus, שנכנסה לתוקף ב-27 ביולי 2026, דחתה את עיקר חובות-הסיכון-הגבוה אל 2 בדצמבר 2027, ואת אלה של מוצרים-מוסדרים אל 2 באוגוסט 2028.