Natively Multimodal Models (מודלים רב-מודליים מיסודם)
הגדרה
המגמה שבה חברות-AI מובילות עברו מהוספת יכולות-תמונה וקול למודל-טקסט קיים ('הדבקה') לאימון מודל אחד מיסודו על כמה סוגי-תוכן בו-זמנית — תבנית שחוזרת כמעט-במקביל אצל OpenAI, גוגל ו-Meta.
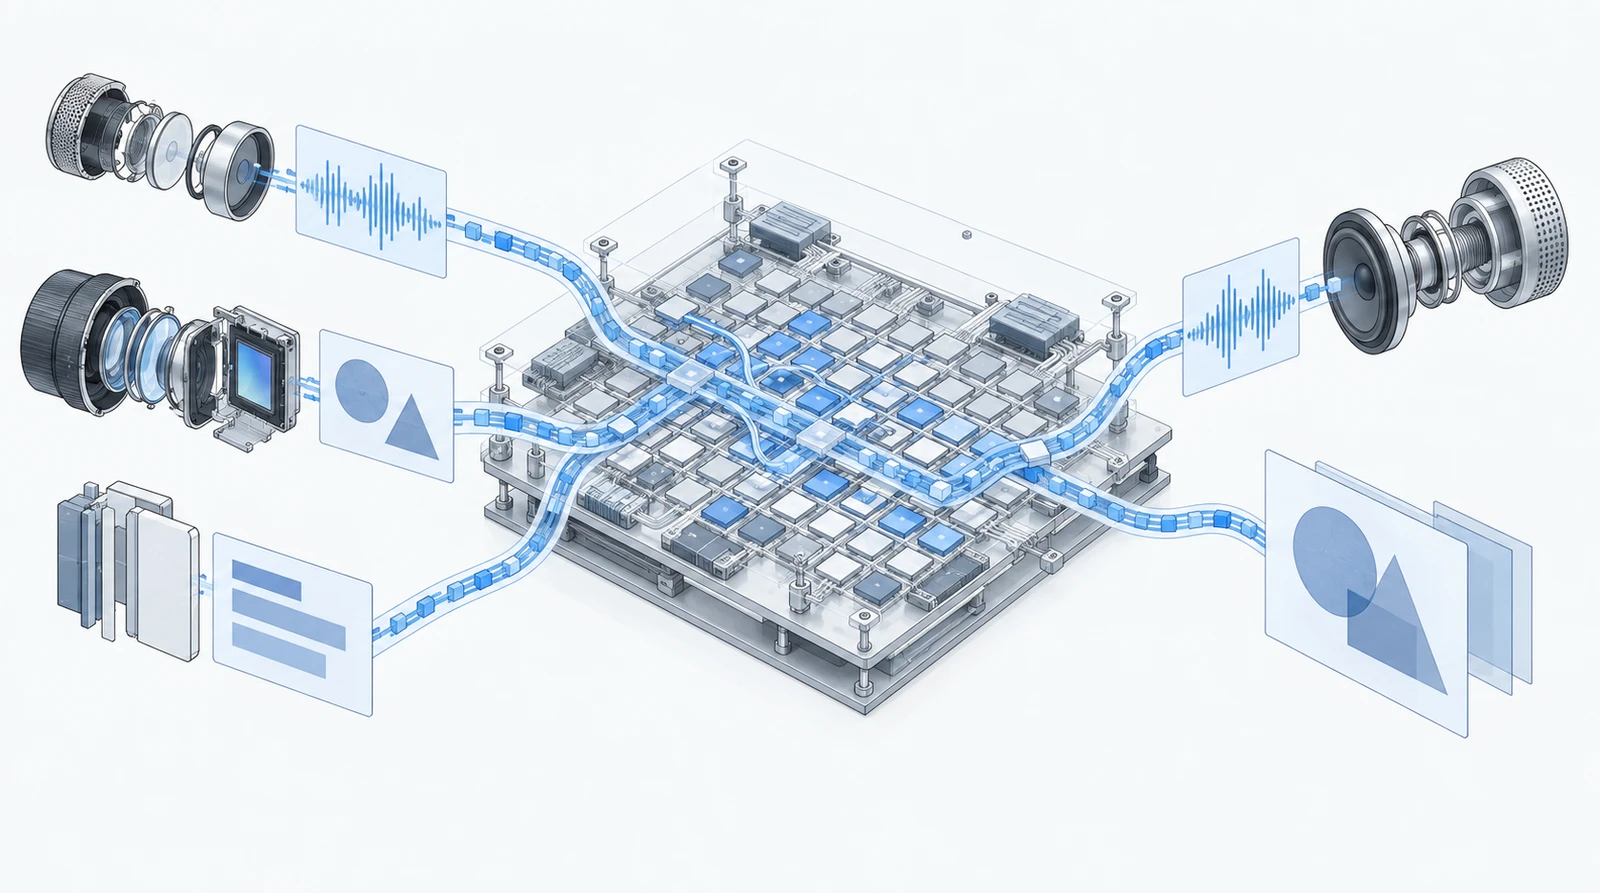
מה ההבדל בין "הדבקה" למודל רב-מודלי מיסודו
רוב מודלי ה-AI המוקדמים שידעו להתמודד עם יותר מסוג-תוכן אחד נבנו בשיטת ה"הדבקה" (Bolt-on): מודל-טקסט קיים, מאומן ומוכן מראש, קיבל רכיב נוסף — למשל מקודד-תמונה נפרד — שמתרגם קלט חזותי לייצוג שהמודל-הטקסטואלי יכול לעבד, בלי שהרשת כולה אומנה מחדש יחד. הערך רב-מודלי (Multimodal) באתר הזה מסביר את העיקרון הבסיסי הזה ואת הדוגמה המוקדמת CLIP של OpenAI מ-2021, ששילבה הבנת-תמונה והבנת-טקסט אבל עדיין הפרידה ביניהן ברמה הארכיטקטונית. המגמה שהערך הזה עוסק בה שונה: מאז 2023–2024 חברות-AI מובילות עברו לאמן מודל אחד, מהיסוד, בו-זמנית על טקסט, תמונה וקול (ולעיתים וידאו) יחד — כך שהמודל "לומד" את הקשר בין המודליות השונות כבר בשלב-האימון, לא מקבל אותו כתוספת מאוחרת. ההבדל הזה נקרא לעיתים "היתוך מוקדם" (Early Fusion) לעומת "היתוך מאוחר" (Late Fusion), ולא מדובר בשיפור-הדרגתי של מודל בודד אלא בתבנית שחוזרת, כמעט באותה תקופה, אצל כמה מהמעבדות המתחרות הגדולות ביותר בתחום.
GPT-4o: ממערכת-קול תלת-שכבתית למודל אומני אחד
הדוגמה הבולטת ביותר היא GPT-4o של OpenAI, ששוחרר ב-13 במאי 2024 (ה-"o" מסמל Omni). לפני GPT-4o, מצב-הקול של ChatGPT פעל בשלושה מודלים נפרדים ברצף: מודל אחד תמלל את הדיבור לטקסט, מודל-שפה טקסטואלי (GPT-4) עיבד את הטקסט וענה, ומודל שלישי המיר את התשובה בחזרה לקול — שרשרת שיצרה השהיה של 2.8 עד 5.4 שניות בממוצע לפי תיעוד עדכני. GPT-4o, לעומת זאת, מעבד קול, טקסט ותמונה בתוך אותה רשת-נוירונים אחת מקצה-לקצה, ולכן יכול להשיב לקלט קולי תוך 232 מילישניות במקרה הטוב, ובממוצע כ-320 מילישניות — קרוב לזמן-תגובה אנושי בשיחה. בשונה מ-GPT-3.5 ומ-GPT-4 הקודמים, שהסתמכו על מודלים נפרדים לעיבוד קול, GPT-4o תומך ב"קול-אל-קול" (Voice-to-voice) באופן טבעי. המודל מקבל כקלט כל שילוב של טקסט, קול, תמונה ווידאו, ומייצר כפלט כל שילוב של טקסט, קול ותמונה — כל זאת מתוך אותה רשת אחת, לא שרשרת של מודלים נפרדים.
Gemini: רב-מודלי כבר בתכנון הראשוני
גוגל דיפמיינד הקדימה את הכיוון הזה: משפחת המודלים Gemini הוצגה ב-6 בדצמבר 2023 — Gemini 1.0 Pro נכנס באותו יום לתוך Bard, ולממשק-ה-API ב-13 בדצמבר 2023 — כשגוגל מדגישה שהמודל תוכנן "רב-מודלי מהיסוד" (Natively Multimodal) — לא כתוספת אלא כעיקרון-עיצוב מהרגע הראשון. מערך-הנתונים שעליו אומן Gemini כלל מסמכי-אינטרנט, ספרים וקוד לצד תמונה, קול ווידאו יחד, לא כערוצים נפרדים שמוזגו בדיעבד. המשפחה כללה שלושה גדלים — Nano לשימוש במכשיר עצמו, Pro לטווח-רחב של משימות, ו-Ultra כגרסה החזקה ביותר. גוגל ו-OpenAI, שתי המעבדות המתחרות ביותר בתחום באותה תקופה, הגיעו אפוא, כל אחת בנתיב-פיתוח נפרד, לאותה תבנית ארכיטקטונית — אימון-מאוחד-ממקור, לא הדבקה.
Llama 4 ו"היתוך מוקדם": גם Meta עוברת לגישה הזו
התבנית חזרה גם אצל Meta, שהיא-עצמה עברה מגרסה-קודמת מבוססת-הדבקה לגרסה רב-מודלית-מיסודה בתוך המשפחה שלה-עצמה. Llama 3.2 Vision, גרסה קודמת של Llama, הוסיפה יכולת-ראייה באמצעות "מתאם-ראייה" (Vision Adapter) נפרד שהורכב על מודל-הטקסט הקיים — דוגמה קלאסית לגישת-ההדבקה. לעומת זאת, משפחת Llama 4 ("Scout" ו-"Maverick"), ששוחררה ב-5 באפריל 2025, מבוססת על מה ש-Meta מכנה "היתוך מוקדם" (Early Fusion): טקסט ותמונה מוזרמים כאסימונים (Tokens) לאותו גב-רשת מאוחד כבר משלב האימון-המקדים, במקום להתחבר דרך רכיב נפרד בשלב מאוחר יותר. Meta טוענת שהגישה מאפשרת ייצוגים משותפים עשירים יותר בין המודליות, ומשווה במפורש את ביצועי Llama 4 Maverick למתחרות ישירות — GPT-4o, Gemini 2.0 Flash ו-DeepSeek v3. המעבר הזה בתוך אותה משפחת-מודלים ממחיש שהמגמה איננה רק תחרות בין חברות, אלא שינוי-כיוון טכני שכל מעבדה גדולה, כולל כזו שכבר תמכה ברב-מודליות בגישה הישנה, אימצה בסופו של דבר.
למה זו מגמה תעשייתית, ולא תכונה של מוצר בודד
מה שהופך את התופעה הזו למגמה, ולא לתיאור-מוצר יחיד, הוא שהשינוי הארכיטקטוני דומה במהותו בשלוש המעבדות: איחוד-מודליות בשלב-האימון במקום צירוף-רכיבים בדיעבד. OpenAI, גוגל ו-Meta הגיעו לתבנית הזו — דצמבר 2023 אצל גוגל, מאי 2024 אצל OpenAI, אפריל 2025 אצל Meta — כל אחת בנתיב-פיתוח נפרד, בלי להמתין לגילוי הפומבי של המתחרות. התוצאה המעשית היא שיכולת-רב-מודלית, שעד 2022–2023 נחשבה תוספת-יוקרה נדירה, הפכה לציפיית-בסיס במודל-דגל מודרני: קול-בזמן-אמת, הבנת-תמונה וניתוח-וידאו, כולם בתוך אותה שיחה. חשוב להבחין בין זה לבין הערך הכללי רב-מודלי, שמסביר את המושג הבסיסי — הערך הזה עוסק בתבנית-ההתפתחות עצמה: איך, מתי, ולמה כמה מעבדות מתחרות אימצו את אותה גישה טכנית כמעט בו-זמנית, ומה מבדיל אותה מהגישה שקדמה לה.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
שאלות נפוצות ❓
מה ההבדל בין "רב-מודלי" ל"רב-מודלי מיסודו"?
רב-מודלי מתאר כל מודל שמתמודד עם יותר מסוג-תוכן אחד, גם אם נבנה בשיטת-הדבקה של רכיבים נפרדים. "רב-מודלי מיסודו" מתאר מודל שאומן מלכתחילה, מקצה-לקצה, על כמה מודליות יחד.
למה GPT-4o נקרא "אומני"?
כי בניגוד לגרסאות קודמות שהסתמכו על שרשרת של שלושה מודלים נפרדים לטיפול בקול, GPT-4o מעבד טקסט, קול ותמונה בתוך אותה רשת-נוירונים אחת מקצה-לקצה.
מה זה "היתוך מוקדם" (Early Fusion)?
שיטת-אימון שבה אסימונים ממודליות שונות (למשל טקסט ותמונה) מוזרמים לאותו גב-רשת מאוחד כבר בשלב האימון-המקדים, בניגוד ל"היתוך מאוחר" שמחבר רכיבים נפרדים בדיעבד.
אילו חברות מובילות את המגמה הזו, ומתי?
גוגל (Gemini, דצמבר 2023), OpenAI (GPT-4o, מאי 2024) ו-Meta (Llama 4, אפריל 2025) — שלוש מעבדות מתחרות שהגיעו לאותה תבנית ארכיטקטונית — כל אחת בנפרד, בין דצמבר 2023 לאפריל 2025.
האם רב-מודליות-מיסודה שיפרה משהו מדיד?
כן, לפחות בתחום אחד מתועד: זמן-התגובה. GPT-4o משיב לקלט קולי תוך 232 מילישניות במקרה הטוב ו-320 מילישניות בממוצע, לעומת 2.8–5.4 שניות במצב-הקול הקודם המבוסס על שלושה מודלים נפרדים.