בדיקות-פריצה יזומות (Red Teaming)
הגדרה
בדיקות-פריצה יזומות (Red Teaming) הוא תהליך שבו מומחים מנסים במכוון "לשבור" מודל AI כדי לגלות ולתקן חולשות לפני שמנצלים אותן.
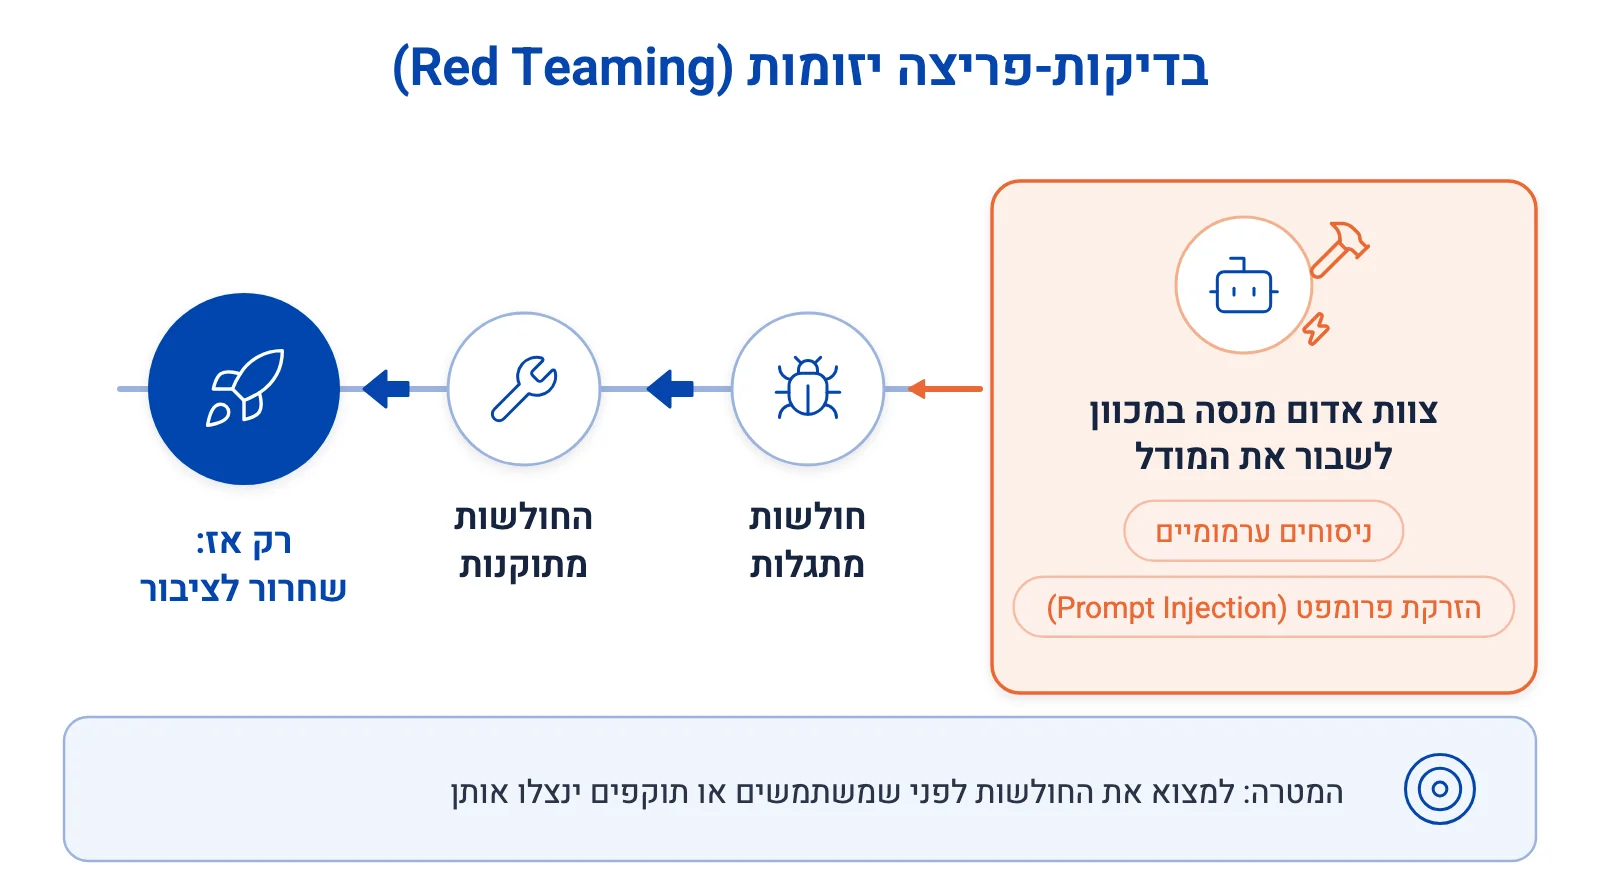
בדיקות-פריצה יזומות (Red Teaming) הוא תהליך שבו מומחים מנסים במכוון "לשבור" מודל AI ולגרום לו להתנהג לא-כשורה — כדי לגלות ולתקן חולשות לפני שמשתמשים אמיתיים, או תוקפים זדוניים, ינצלו אותן. הצד ש"תוקף" נקרא "צוות אדום" והצד המתגונן "צוות כחול" — מינוח שמקורו בתרגילי-מלחמה-קרה של תאגיד המחקר RAND בשנות ה-60, שבהם "אדום" ייצג את ברית-המועצות ו"כחול" את ארצות-הברית.
מקרה מוקדם ומעניין של אותו רעיון בדיוק — אתגור-שיטתי של הנחות-יסוד לפני שהן מתגלות כשגויות מדי-מאוחר — צץ בישראל: אחרי מלחמת יום-הכיפורים ב-1973, שבה כשל-מודיעיני חמור הפתיע את המדינה, הוקם באגף-המודיעין (אמ"ן) גוף בשם "איפכא מסתברא" שתפקידו הפורמלי היה לאתגר במכוון את ההנחות הרווחות ולמנוע חשיבה-קבוצתית — תקדים מוקדם לרעיון שהפך היום לסטנדרט בבדיקות-AI.
ב-AI, הרעיון מתורגם לניסיונות מכוונים לעקוף מעקות-בטיחות — לגרום למודל לחשוף מידע מסוכן או להתנהג באופן בלתי-צפוי, דרך ניסוח פרומפטים ערמומיים או "הזרקת-פרומפט" (Prompt Injection). רוב חברות ה-AI המובילות מפעילות צוותי red teaming פנימיים, ולעיתים אף שוכרות חוקרי-אבטחה חיצוניים לפני שחרור מודל חדש לציבור הרחב, בניסיון למצוא סוגי-חולשות שצוות פנימי קטן היה עלול לפספס — בדיוק כפי שגוף בדיקות-חדירה חיצוני לרשת-מחשבים לרוב מגלה בעיות שהצוות הפנימי "התרגל" אליהן ולא שם-לב אליהן יותר.
מחקר אקדמי מ-2025 שנסקר ב-PLOS ONE מציין שהתחום מתפתח כעת גם לכיוון ניתוח-שיטתי של מודלי-שפה גדולים (LLM — Large Language Model) ספציפית, מעבר לבדיקות-חדירה מסורתיות של רשתות-מחשבים — כי הפגיעויות הייחודיות למודלי-שפה (כמו הזרקת-פרומפט או "שכנוע" המודל להתעלם מהנחיות) שונות מהותית מהפגיעויות שבדיקות-חדירה קלאסיות תוכננו לגלות — מה שהופך את בדיקות-הפריצה היזומות למקצוע מתפתח בפני עצמו, לא רק גרסה חדשה לאבטחת-מידע ותיקה.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות