מעקות בטיחות (Guardrails)
הגדרה
מעקות בטיחות (Guardrails) הם כללים והגבלות שמוטמעים במודל AI כדי למנוע ממנו לספק תוכן מזיק, מסוכן או בלתי הולם.
💡 דוגמה
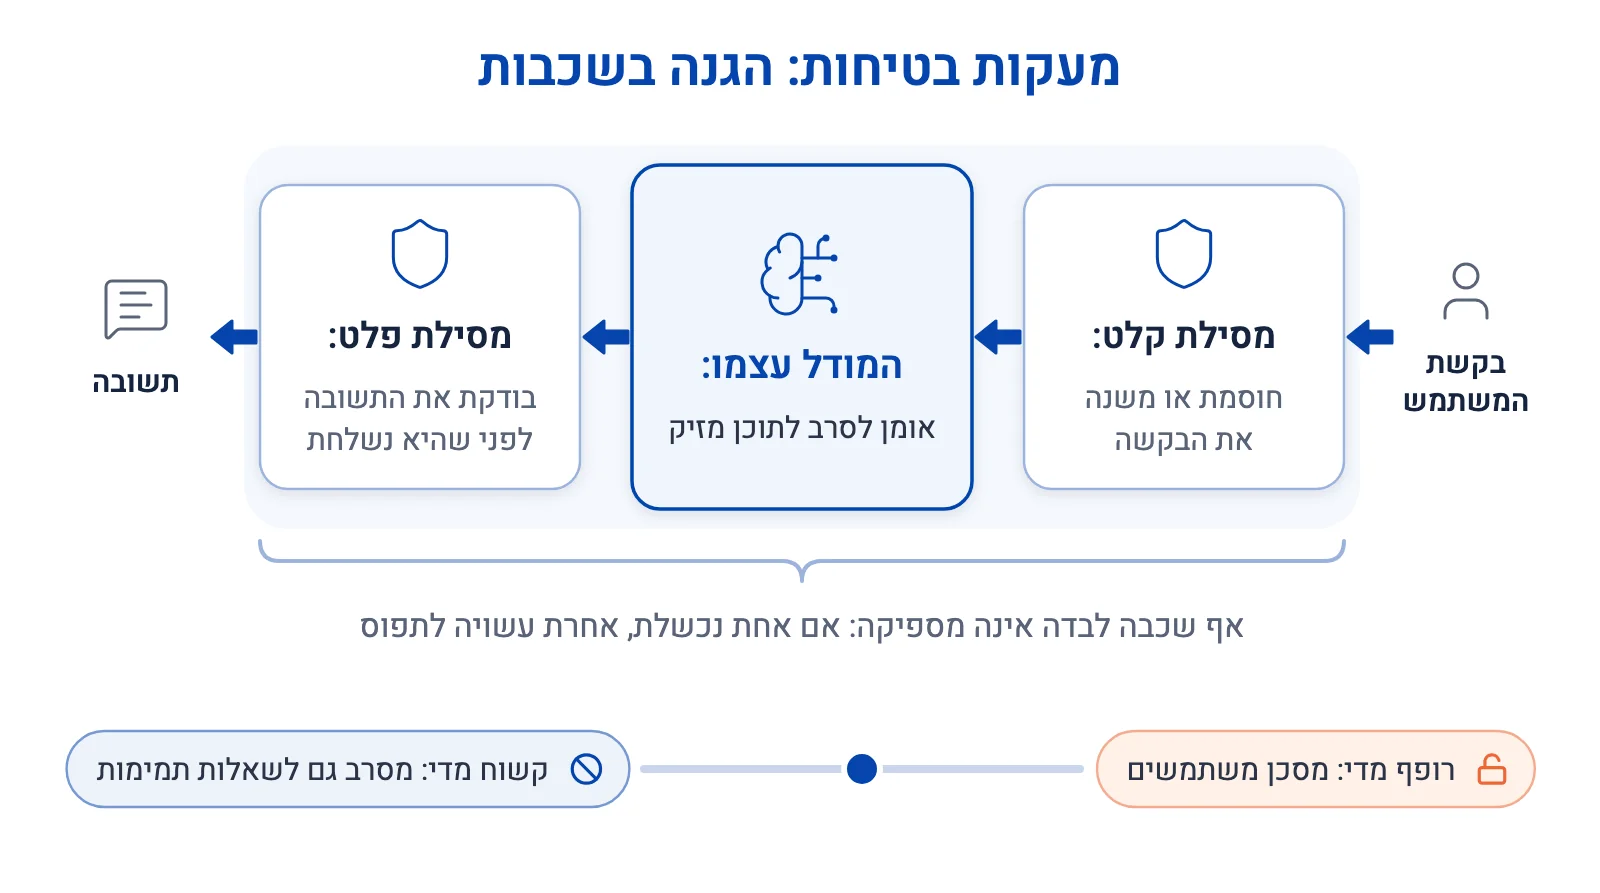
מבקשים מצ'אט הוראות להכנת חומר נפץ, והוא מסרב. זה מעקה בטיחות. אבל כשהמעקות קשוחים מדי, הוא מסרב גם לשאלה תמימה לגמרי.
מה מעקות-בטיחות: ההגדרה והאנלוגיה
מעקות בטיחות (Guardrails) הם כללים והגבלות שמוטמעים במודל AI — בדרך-כלל דרך פרומפט-מערכת ואימון ייעודי — כדי למנוע ממנו לספק תוכן מזיק, מסוכן, או בלתי-הולם. השם שאול ממעקה-הבטיחות הפיזי לצד כביש הררי: לא מונע מהנהג לנווט את הרכב, אבל עוצר אותו לפני שהוא יורד מהכביש לגמרי. מעקות בטיחות טיפוסיים כוללים סירוב לספק הוראות ליצירת נשק או חומרים מסוכנים, הימנעות ממתן ייעוץ רפואי או משפטי מוסמך, וחסימת תוכן פוגעני.
שכבות-הגנה: מאימון ועד מסגרת-תכנות ייעודית כמו NeMo Guardrails
מעקות פועלים בכמה שכבות משלימות: באימון המודל עצמו (למשל דרך למידת-חיזוק מפידבק אנושי), ובבדיקות נוספות ונפרדות שרצות על הקלט והפלט בזמן-אמת — כך שגם אם שכבה אחת נכשלת, השנייה עשויה לתפוס את הבעיה. העיקרון שביסוד הריבוד הזה שאול מאבטחת-מידע מסורתית ונקרא "הגנה-בעומק" (Defense in Depth): אף שכבת-הגנה בודדת, כולל האימון עצמו, לא נחשבת מספיקה בפני עצמה, כי כל שכבה יכולה להיכשל בנסיבות שלא נצפו מראש. חברות AI מתעדות לרוב את המדיניות הזו במסמך פומבי (למשל "מדיניות-שימוש-מקובל"), כדי שגם מפתחים חיצוניים שבונים מעליו יידעו למה לצפות.
מסגרות-תכנות ייעודיות הופכות את השכבתיות הזו למוצר-קוד-פתוח מוחשי: NeMo Guardrails, שפרסמה NVIDIA כקוד-פתוח, מגדירה חמישה סוגי "מסילות" (Rails) נפרדות — מסילת-קלט שיכולה לחסום או לשנות מה שהמשתמש כתב, מסילת-דיאלוג שמשפיעה על איך המודל עצמו מנוסח, מסילת-אחזור למקרה של שליפה-מועשרת (RAG), מסילת-הרצה סביב כלים חיצוניים, ומסילת-פלט שיכולה לחסום את תשובת-המודל הסופית — כל אחת נכתבת בשפת-דגמים ייעודית בשם Colang, בתחביר דמוי-Python.
מקרה מתועד: מה קורה בהיעדר מעקות בכלל — Tay, 2016
מקרה מתועד שממחיש מה קורה בהיעדר מעקות: בשנת 2016 שחררה מיקרוסופט את הצ'אטבוט Tay בטוויטר, בוט שנועד ללמוד מהאינטראקציה עם משתמשים. תוך 16 שעות בלבד, אחרי שקבוצת-משתמשים "לימדה" אותו במכוון ביטויים גזעניים ופוגעניים, מיקרוסופט נאלצה להוריד אותו לגמרי — כי הבוט חיקה כל מה שנאמר לו, בלי שכבת-סינון שתבחין בין תוכן לגיטימי לתוכן מזיק.
עקיפת מעקות קיימים: jailbreak מול הזרקת-פרומפט
מקרה Tay ממחיש היעדר-מעקות מוחלט, אבל כשל שכיח לא-פחות הוא מעקות שכן קיימים אך נעקפים. סיימון וויליסון (Simon Willison), שהפיץ את המונח "הזרקת-פרומפט" (Prompt Injection) בספטמבר 2022, מבחין בין שני מנגנוני-עקיפה שקל לערבב ביניהם: "פריצה" (Jailbreak) היא ניסיון-עקיפה ישיר של המעקות עצמם — למשל לשכנע את המודל לשחק "דמות" בדיונית שלא כפופה למדיניות; הזרקת-פרומפט מנצלת חולשה עמוקה-יותר — חוסר-היכולת של המודל להבחין בין הוראת-מערכת שהמפתח כתב לבין טקסט-משתמש, או תוכן חיצוני שהמודל קורא (כמו דף-אינטרנט או מסמך), שמנסה להתחזות להוראה. ההבדל קריטי כי כל שכבת-מעקה שתוארה למעלה — מסילת-קלט, מסילת-פלט — יכולה להיכשל מול שני סוגי-התקיפה האלה בדרכים שונות-לגמרי, ודורשת התמודדות נפרדת לכל אחד: הגנה מפני jailbreak מתמקדת בחיזוק ההתנהגות של המודל עצמו מול ניסיון-שכנוע ישיר, ואילו הגנה מפני הזרקת-פרומפט דורשת גם לסנן ולתייג תוכן-חיצוני עוד לפני שהוא מגיע למודל בכלל.
האיזון העדין: רופף מדי מול קשוח מדי
איזון מעקות הבטיחות הוא אתגר עדין ומתמשך: מעקות רופפים-מדי מסכנים משתמשים, בדיוק כמו מקרה Tay; מעקות קשוחים-מדי הופכים את המודל למתחמק ופחות-שימושי גם בבקשות לגיטימיות לחלוטין — משתמשים רבים מתלוננים על מודל שמסרב לענות גם על שאלות תמימות, מחשש-יתר. זהו בדיוק המתח שנתקלים בו בפיתוח כל מוצר AI רציני, ואין לו פתרון "נכון" אחד וקבוע — כל עדכון-מודל מחדד מחדש את האיזון בין הגנה למידה שימושית, ובדיוק בגלל זה מסגרות כמו NeMo Guardrails מאפשרות למפתח לכוונן כל מסילה בנפרד, במקום מתג גורף אחד של "יותר" או "פחות" בטיחות.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
🎯 נסו בעצמכם · 2 דקות
בשתי דקות, בקשו מצ'אטבוט לנסח שלושה כללי בטיחות לעוזר שמסביר נושאים רפואיים בלי לתת ייעוץ מוסמך. בקשו דוגמה לתשובה כללית שמכבדת את הכללים. הניסוח אינו התקנה של מנגנון הגנה.
מתוך מונח השבוע של Wiki-AI.
שאלות נפוצות ❓
איך מעקות-בטיחות שונים ממדיניות-שימוש כתובה?
מדיניות-שימוש היא מסמך שמתאר מה מותר ואסור; מעקות הם היישום הטכני שאוכף את זה בפועל — באימון המודל ובבדיקות-קלט/פלט בזמן-אמת, לא רק בכתב.
מה ההבדל בין jailbreak להזרקת-פרומפט?
jailbreak מנסה לעקוף ישירות את המעקות, למשל לשכנע את המודל לשחק דמות בלי-מגבלות; הזרקת-פרומפט מנצלת את חוסר-היכולת של המודל להבחין בין הוראת-מפתח לטקסט-משתמש או תוכן-חיצוני.
מה זה NeMo Guardrails?
מסגרת-קוד-פתוח של NVIDIA שמאפשרת למפתחים להגדיר חמישה סוגי-מסילות נפרדות — קלט, דיאלוג, אחזור, הרצת-כלים ופלט — בשפת-דגמים ייעודית בשם Colang, במקום מתג-בטיחות גורף אחד.
מה לימד מקרה Tay על הצורך במעקות?
שבלי שכבת-סינון, בוט שלומד מאינטראקציה עם משתמשים יכול להידרדר תוך שעות בודדות — Tay הורד תוך 16 שעות אחרי שקבוצת-משתמשים לימדה אותו במכוון ביטויים פוגעניים.
האם אפשר להגזים במעקות?
כן — מעקות קשוחים-מדי הופכים מודל למתחמק גם בבקשות לגיטימיות, ומחייבים איזון מתמשך בכל עדכון-מודל, לא החלטה חד-פעמית.