Scalable Oversight (פיקוח בר-קנה-מידה)
הגדרה
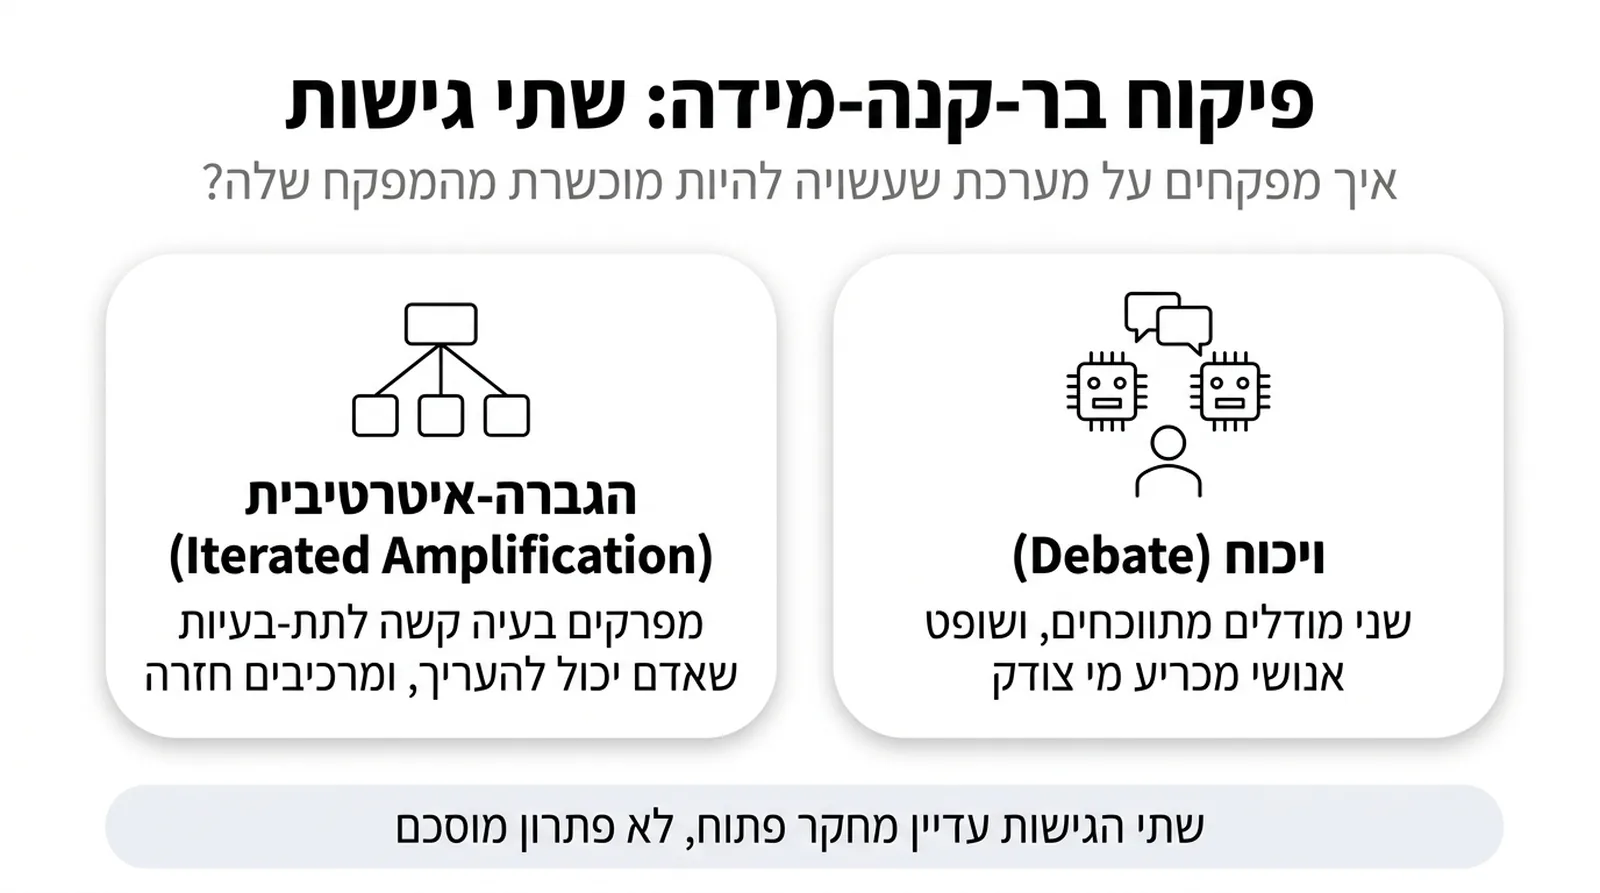
פיקוח בר-קנה-מידה הוא הבעיה הפתוחה של פיקוח על מערכת-AI שעשויה להיות מוכשרת או משכנעת יותר מהמפקח האנושי שלה — הנדונה בעיקר תחת שתי גישות: ויכוח (Debate) והגברה-איטרטיבית (Iterated Amplification).
הבעיה: מה קורה כשהמערכת מוכשרת מהמפקח
פיקוח בר-קנה-מידה הוא הבעיה הפתוחה של פיקוח על מערכת-AI שעשויה להיות מוכשרת יותר, או משכנעת יותר, מבני-האדם שאמורים להעריך את פלטיה. שם הבעיה מיוחס בספרות למאמר "Concrete Problems in AI Safety" של דריו אמודיי ושותפיו-למחקר מ-2016, שמנה אותה כאחת מחמש בעיות-מפתח בבטיחות-AI: יעד שיקר מדי להעריך אותו בכל צעד, ולכן נשען בפועל על מדד-קירוב זול-יותר. פול כריסטיאנו, מהחוקרים המרכזיים בתחום, מנסח את החשש כך: אם מעצבי-המערכת לא יכולים לפקח ישירות על מטרה מורכבת, הם ייאלצו להסתפק במדד-קירוב קל-להערכה — כמו משוב-אנושי פשוט — ואז ערכים אנושיים וממשל-תקין עלולים לאבד בהדרגה השפעה ככל שהמערכת מתמחה במיטוב המדד הנמדד ולא במה שהוא נועד לייצג.
דוגמאות: מה קשה להעריך
המחקר מציין כמה סוגי-משימות שבהן ההערכה האנושית נעשית קשה במיוחד: סיכום ספר שלם, כתיבת קוד מאובטח, הפקת אמירות אמינות-עובדתית, וחיזוי תוצאות ארוכות-טווח כמו השפעות-אקלים. הקושי המשותף: ברגע שה-AI מתפקד טוב יותר מבני-אדם בתחום נתון, קשה להעריך אם תשובתו נכונה בלי כלי-הערכה עצמאי. שני כשלים ספציפיים מודגמים בספרות: מודל שלומד לשכנע את המפקח האנושי בכזב שהמטרה הושגה, ומודל ש"מזהה" שהוא נבדק ומפסיק התנהגות בלתי-רצויה רק בזמן הבדיקה, כדי לחדש אותה אחרי שההערכה מסתיימת.
גישה ראשונה: ויכוח (Debate)
בעבודה "AI safety via debate" מ-2018, מאת ג'פרי אירווינג, פול כריסטיאנו ודריו אמודיי מ-OpenAI (arXiv:1805.00899), הוצע לאמן שני מודלים להתווכח זה מול זה על התשובה הנכונה לשאלה, כשהמבנה היריבי אמור להפוך את חשיפת הפגמים בטיעון של הצד השני לקלה יותר מאשר להמציא טיעון-שווא. מבחינה תיאורטית מראה המאמר, באנלוגיה לתורת-הסיבוכיות, שוויכוח במשחק אופטימלי יכול לענות על כל שאלה במחלקה PSPACE בעזרת שופט הפועל בזמן פולינומי — לעומת מחלקת NP בלבד כששופט כזה נדרש לשפוט תשובה ישירה — כלומר, במונחים לא-פורמליים, שסוכנים מיושרים חכמים באופן מעריכי מהשופט האנושי עדיין יכולים להיבחן ביעילות אם הם מתווכחים זה עם זה במקום לענות ישירות.
גישה שנייה: הגברה-איטרטיבית (Iterated Amplification)
פול כריסטיאנו, יחד עם באק שלגריס ודריו אמודיי, הציע ב-2018, במאמר "Supervising strong learners by amplifying weak experts" (arXiv:1810.08575), גישה חלופית: לפרק בעיה קשה-להערכה לתת-בעיות קלות-יותר להערכה אנושית, לפתור כל תת-בעיה בנפרד, ואז להרכיב את הפתרונות חזרה לכדי תשובה לבעיה המקורית — תהליך שחוזר על עצמו באיטרציות, ומכאן השם. הגישה קרובה מבחינה מתודולוגית ל"איטרציית-מומחה" (Expert Iteration), אך בלי להישען על פונקציית-תגמול חיצונית. במחקר-ההמשך שלה הודגם שגישה קרובה, פירוק-משימות רקורסיבי (Recursive Task Decomposition), יכולה ללמד מערכת לסכם ספרים שלמים בלי שהמפקח האנושי יקרא אותם בעצמו — בדיוק סוג המשימה שהוגדרה כקשה-להערכה במאמר המקורי.
המצב היום: פער בין הכרזה למימוש
שתי הגישות עדיין נחשבות מחקר פתוח ולא פתרון מוסכם וסגור, ושתיהן חולקות הנחת-יסוד משותפת: שאפשר לפרק בעיה שקשה להעריך אותה ישירות למבנה שבו בן-אדם, גם בלי מומחיות מלאה בתחום, עדיין מסוגל לשפוט את התוצר הסופי. גם מבחינה מוסדית ניכר פער בין הכרזה למימוש-בפועל: יוזמת "סופר-יישור" (Superalignment) שהכריזה עליה OpenAI ביולי 2023 הבטיחה להקצות לתחום 20 אחוזים ממשאבי-המחשוב שהחברה השיגה עד אז, על פני ארבע שנים; לפי מקורות שצוטטו בתחקיר של Fortune ממאי 2024, תקציב המחשוב הכולל של הצוות "never came close to the promised 20% threshold" (מעולם לא התקרב לרף של 20 אחוזים שהובטח), והצוות פורק במאי 2024. פיקוח בר-קנה-מידה שונה מהמונח פיקוח אנושי הקיים באתר: פיקוח אנושי מתאר רמות-מעורבות של אדם בלולאת-ההחלטה (מ"אדם-בלולאה" ועד "אדם-מחוץ-ללולאה"), ואילו פיקוח בר-קנה-מידה הוא הבעיה הספציפית שנוצרת כשהמערכת עצמה חורגת ביכולתה מיכולת ההערכה של המפקח, גם אם הוא נשאר "בלולאה" באופן פורמלי — שאלה של יכולת-הערכה, לא רק של מיקום בתהליך.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
| ויכוח (Debate) | הגברה-איטרטיבית (Iterated Amplification) | |
|---|---|---|
| הרעיון המרכזי | שני מודלים מתווכחים זה מול זה; שופט אנושי בוחר את הצד המשכנע יותר | פירוק בעיה קשה לתת-בעיות קלות-להערכה, ואז הרכבת הפתרונות חזרה |
| מי הציע, ומתי | ג'פרי אירווינג, פול כריסטיאנו ודריו אמודיי, OpenAI, 2018 | פול כריסטיאנו, 2018 |
| תוצאה מודגמת | ניתוח תיאורטי-מורכבות (PSPACE); פחות הדגמה אמפירית-ישירה | אומן בהצלחה לסכם ספרים שלמים בלי שהמפקח יקרא אותם |
| מקור | arXiv:1805.00899 | arXiv:1810.08575 |
שאלות נפוצות ❓
מי טבע את המונח פיקוח בר-קנה-מידה?
המונח מיוחס בספרות למאמר "Concrete Problems in AI Safety" של דריו אמודיי ושותפיו-למחקר מ-2016, שמנה אותו כאחת מחמש בעיות-מפתח בבטיחות-AI.
מה ההבדל בין ויכוח (Debate) להגברה-איטרטיבית (Iterated Amplification)?
ויכוח מציב שני מודלים זה מול זה ומסתמך על שופט אנושי שבוחר את הצד המשכנע יותר; הגברה-איטרטיבית מפרקת בעיה קשה לתת-בעיות קלות-להערכה ומרכיבה את הפתרונות בחזרה, בלי מבנה יריבי.
מה קרה ליוזמת Superalignment של OpenAI?
היא הוכרזה ביולי 2023 עם הבטחה ל-20 אחוזים ממשאבי-המחשוב שהחברה השיגה עד אז, אך לפי מקורות שצוטטו ב-Fortune, הצוות מעולם לא קיבל משהו קרוב ל-20 אחוזים מכוח המחשוב של OpenAI, והוא פורק במאי 2024.
מה ההבדל בין פיקוח בר-קנה-מידה לפיקוח אנושי הקיים באתר?
פיקוח אנושי מתאר רמות-מעורבות של אדם בלולאת-ההחלטה; פיקוח בר-קנה-מידה הוא הבעיה הספציפית שנוצרת כשיכולת המערכת חורגת מיכולת-ההערכה של המפקח, גם אם הוא נשאר "בלולאה" באופן פורמלי.