חלון הקשר (Context Window)
הגדרה
חלון הקשר (Context Window) הוא כמות הטקסט שמודל שפה "זוכר" ומביא בחשבון בו-זמנית בשיחה אחת.
💡 דוגמה
בשיחה ארוכה מאוד, הצ'אט פתאום "שוכח" מה סיפרתם לו בהתחלה. זה לא באג: המידע הישן כבר יצא מחלון ההקשר.
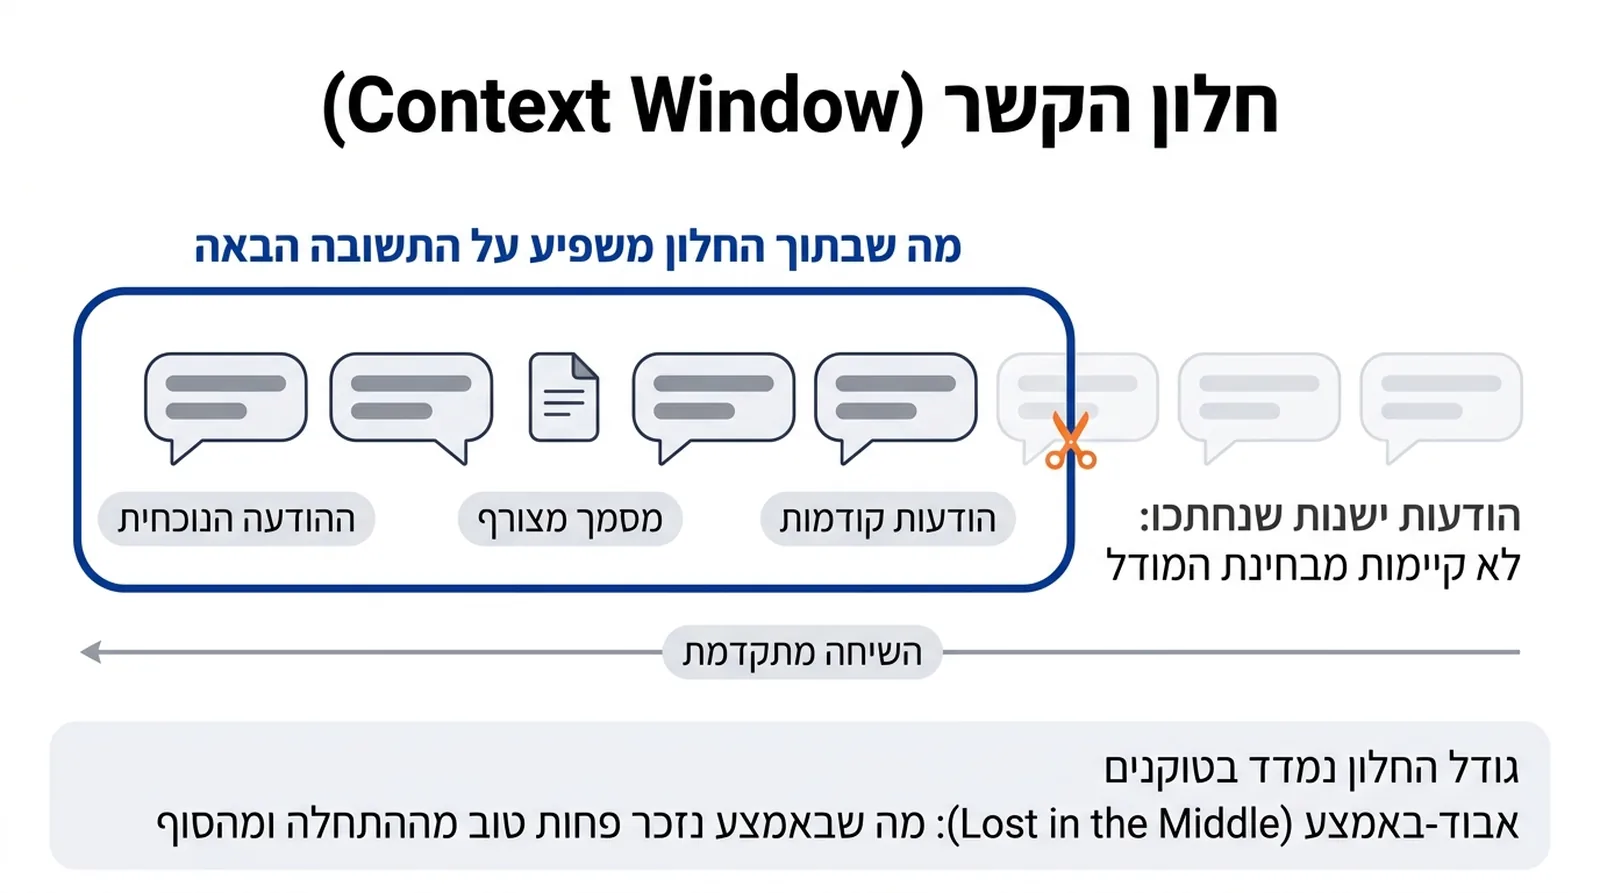
מה זה חלון-הקשר, ומה קורה כשהשיחה חורגת ממנו
חלון הקשר (Context Window) הוא כמות הטקסט — נמדדת בטוקנים (Token, יחידות-הטקסט הקטנות שמודל שפה מעבד) — שמודל שפה גדול (LLM) "רואה" ולוקח בחשבון בו-זמנית בתוך שיחה אחת. כל מה שנכנס לחלון הזה — ההודעה הנוכחית של המשתמש, כל ההודעות הקודמות באותה שיחה, וכל מסמך שצורף אליה — משפיע על התשובה הבאה; כל מה שנשאר מחוצה לו, גם אם נאמר קודם באותה שיחה, פשוט לא קיים מבחינת המודל ברגע יצירת התשובה. חלון-ההקשר קיים בגלל אילוץ הנדסי בסיסי של ארכיטקטורת הטרנספורמר (Transformer) שרוב מודלי השפה בנויים עליה: מנגנון תשומת-הלב (Attention) שלה בוחן כל טוקן מול כל טוקן אחר, כך שהחישוב הדרוש גדל ביחס ריבועי לאורך הקלט — אורך-הקשר גדול הרבה יותר פירושו עלות-חישוב וזיכרון גדולים הרבה יותר, לא רק תוספת ליניארית.
כשאורך השיחה חורג מגודל חלון ההקשר, המידע הישן ביותר "נשכח" בפועל בשיטה הפשוטה ביותר של יישום — הוא פשוט נחתך ולא נכנס יותר לחישוב, גם אם הוזכר קודם באותה שיחה. זו הסיבה שצ'אטבוט עלול "לשכוח" הנחיה שניתנה בתחילת שיחה ארוכה מאוד, גם אם הוא "זכר" אותה כל הזמן קודם לכן. יישומים מסחריים מתקדמים יותר מטפלים בזה בכמה דרכים: חלקם מסכמים אוטומטית את החלק הישן של השיחה במקום לזרוק אותו לגמרי, כדי לשמר לפחות את התמצית; אחרים מיישמים "זיכרון" נפרד שמאוחסן מחוץ לחלון-ההקשר עצמו ומוזן-מחדש כשהוא רלוונטי — קרוב ברעיונו לטכניקת אחזור-מוגבר-בייצור (RAG), אלא שהמאגר במקרה הזה הוא היסטוריית-השיחה של המשתמש עצמו, לא מאגר-ידע חיצוני.
הגידול הדרמטי: ממודל שזוכר אלפי מילים למיליוני טוקן
חלונות ההקשר גדלו דרמטית בשנים האחרונות — ממודלים שזכרו רק כמה אלפי מילים בדורות הראשונים, למודלים מודרניים שמסוגלים להחזיק במקביל מסמכים שלמים או אפילו ספרים. Gemini של Google היה מהראשונים שהציגו קפיצה דרמטית בתחום: Gemini 1.5, שפורסם ב-2024, תיאר במאמר-המחקר הרשמי שלו יכולת עיבוד של עד מיליון טוקן בהקשר אחד — ולפי אותו מאמר, גרסאות-מחקר פנימיות נבדקו אף עד עשרה מיליון טוקן. הקפיצה הזו לא הייתה רק "עוד קצת יותר גדול" מהדורות הקודמים אלא שינוי-סדר-גודל שהפך שימושים שלמים לישימים לראשונה — כמו הזנת ספר שלם, בסיס-קוד תוכנה שלם, או שעה של סרטון, ובקשה מהמודל לענות על שאלות שדורשות הבנה של החומר כולו בבת-אחת.
מפורסם מול אפקטיבי: תופעת "אבוד-באמצע"
חשוב להבחין בין "חלון-הקשר מפורסם" (Advertised) לבין "חלון-הקשר אפקטיבי" (Effective) — ההבדל ביניהם הוא אחת התגליות המרכזיות במחקר-ההערכה של השנים האחרונות. מבחן "מחט-בערמת-שחת" (Needle in a Haystack) — שבו מטמינים עובדה ספציפית ומדויקת בתוך טקסט ארוך מאוד, ובודקים אם המודל מצליח לאתר ולצטט אותה נכון — הראה שמודלים רבים "זוכרים" עובדות שנמצאות בתחילת ההקשר ובסופו טוב יותר משמעותית מעובדות שנמצאות באמצעו, תופעה שנקראת "אבוד-באמצע" (Lost in the Middle, מ-2023). כתוצאה מכך, חלון-הקשר של מיליון טוקן "מפורסם" לא אומר שהמודל ישתמש בכל המיליון באותה אמינות — בפועל, ביצועים על משימות שדורשות דיוק ואחזור-מדויק נוטים להידרדר משמעותית ככל שמתקרבים לגבול המפורסם, לא נשארים קבועים לאורך כולו.
עלות, וההשוואה מול RAG
עלות היא שיקול מעשי הדוק לגודל חלון-ההקשר, כי רוב שירותי-ה-AI המסחריים מתמחרים לפי כמות-הטוקנים המעובדת, לא רק לפי אורך-התשובה. שיחה שממלאת חלון-הקשר של מיליון טוקן עולה, כמעט תמיד, פי אלפים ממה שעולה שאלה קצרה — וההבדל בין ספקים שונים בתמחור-לטוקן יכול להיות משמעותי מאוד, מה שהופך את הבחירה "איזה מודל להשתמש בו לאיזו משימה" לשיקול כלכלי ולא רק שיקול-יכולות טכני. הזיכרון-הפנימי הדרוש לעיבוד הקשרים ארוכים גדל גם הוא (לא רק זמן-החישוב), מה שמסביר למה חלק מהספקים מציעים תמחור מדורג — עלות גבוהה יותר לטוקן ככל שגודל-ההקשר הכולל בשיחה גדל.
חלון-הקשר גדול מציע חלופה של-ממש לטכניקת אחזור-מוגבר-בייצור (RAG) במקרים מסוימים: במקום לבנות מנגנון-חיפוש נפרד שמאתר את הקטעים הרלוונטיים ממאגר-מסמכים, אפשר "לזרוק" את כל המסמכים הרלוונטיים ישירות לתוך הפרומפט ולסמוך על המודל שימצא בעצמו את מה שנחוץ. הגישה הזו פשוטה יותר הנדסית — אין שכבת-איחזור נפרדת לתחזק — אבל יקרה ואיטית יותר לכל שאילתה בודדת, ופחות מדויקת כשמאגר-המידע גדול (אלפי מסמכים ומעלה) בגלל תופעת "אבוד-באמצע" שתוארה למעלה. המסקנה המעשית שרוב הצוותים המקצועיים הגיעו אליה: חלון-הקשר גדול הוא כלי מצוין למסמך בודד או קומץ-מסמכים קטן, ו-RAG נשאר עדיף כשמדובר במאגרי-ידע גדולים באמת.
ריקבון-הקשר, והתחרות שהאיצה את הגידול
תופעה מעניינת שקשורה לחלון-הקשר, שפחות מדוברת מחוץ לקהילה הטכנית, נקראת "ריקבון-הקשר" (Context Rot) — ירידה בביצועי המודל ככל שהקלט מתארך, גם כשכל המידע הרלוונטי עדיין נמצא בתוך חלון-ההקשר ולא נחתך, ואפילו רחוק מגבול-החלון המפורסם. מחקר ייעודי שפרסמה חברת Chroma ביולי 2025, שבחן 18 מודלים מובילים (כולל משפחות GPT, Claude, Gemini, ו-Qwen), הראה שביצועים יורדים בעקביות עם אורך-הקלט אפילו במשימות פשוטות-לכאורה כמו שליפת-מידע והעתקת-טקסט — לא רק במשימות-היגיון מורכבות. ההסבר המקובל הוא שריבוי-מידע, כולל מידע לא-רלוונטי או חוזר-על-עצמו, "מדלל" את תשומת-הלב של המודל ומקשה עליו להתמקד במה שבאמת חשוב לתשובה הנוכחית — לא שונה עקרונית מאדם שקשה לו להתרכז בפרט אחד בתוך פגישה ארוכה ועמוסה. בגלל זה, גם כשחלון-ההקשר טכנית "מרשה" להזין עוד ועוד מידע, שיחות ארוכות במיוחד או ניקוי-והתחלה-מחדש של שיחה יכולים בפועל לשפר איכות-תשובה, לא רק לחסוך עלות.
ההתפתחות ההיסטורית של חלון-ההקשר משקפת גם תחרות-ישירה בין החברות המובילות, לא רק שיפור-הדרגתי טבעי. עד 2023 חלון-הקשר של כמה אלפי טוקנים בלבד נחשב סטנדרטי, וגם קפיצה לעשרות-אלפי-טוקנים נתפסה כהישג משמעותי. ב-2024 המרוץ האיץ באופן חד: תוך כמה חודשים בודדים עברו הספקים המובילים מעשרות-אלפי טוקנים למאות-אלפים ואז למיליון, כשהאתגר ההנדסי המרכזי לא היה רק "לבנות מודל שמקבל קלט ארוך" אלא לעשות זאת בלי לפגוע באיכות-התשובה על קלטים קצרים-רגילים, שהם עדיין רוב-מוחלט השימוש בפועל של רוב המשתמשים.
לא זיכרון-לטווח-ארוך: ההבדל בין עיבוד לזיכרון
לבסוף, כדאי לזכור שחלון-ההקשר, ככל שיתרחב, לא הופך את המודל ל"בעל-זיכרון-לטווח-ארוך" באופן שדומה לזיכרון אנושי. גם חלון של מיליון טוקן מתאפס לגמרי בתחילת כל שיחה חדשה — המודל לא "זוכר" אתכם מהשיחה הקודמת אלא אם מישהו הזין מחדש את ההיסטוריה הרלוונטית, בין אם ידנית ובין אם דרך מנגנון-זיכרון שהמוצר עצמו מנהל מאחורי-הקלעים. ההבחנה הזו — בין "יכולת לעבד הרבה טקסט בבת-אחת" לבין "זיכרון מתמשך לאורך זמן" — היא אחת מנקודות-הבלבול הנפוצות ביותר אצל משתמשים לא-טכניים שמניחים שחלון-הקשר גדול פירושו שהמודל "מכיר אותם" לאורך זמן. מוצרים מסחריים מסוימים בנו מעליו שכבת-מוצר נפרדת שנועדה לגשר על הפער הזה — "זיכרון" שנשמר בין שיחות שונות ומוזן-מחדש אוטומטית בתחילת כל שיחה חדשה — אבל זו תכונת-מוצר שנבנתה במיוחד, לא תוצאה טבעית של גודל חלון-ההקשר עצמו, וכל ספק מיישם אותה בצורה שונה מעט. כשבודקים כלי-AI חדש שכולל "זיכרון בין שיחות", שווה לברר במפורש איך זה עובד בפועל — האם מדובר בסיכום אוטומטי שנשמר ומוזן-מחדש, או במנגנון-איחזור נפרד שבוחר מה רלוונטי מתוך היסטוריה ארוכה — כי ההבדל משפיע ישירות על מה שהמערכת "זוכרת" נכון ומה היא עלולה לפספס.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
| חלון-הקשר המורחב | RAG | |
|---|---|---|
| התאמה טבעית | מסמך בודד או קומץ-מסמכים | מאגר-ידע גדול ומתעדכן |
| דיוק על קלט ארוך מאוד | יורד ("אבוד-באמצע", "ריקבון-הקשר") | יציב יחסית — שולף רק את הרלוונטי |
| עלות לשאילתה | גבוהה ככל שהקלט ארוך יותר | קבועה יחסית, פחות תלויה בגודל-המאגר |
| מורכבות הקמה | נמוכה — רק להזין את הטקסט | גבוהה יותר — נדרש מנגנון-איחזור |
🎯 נסו בעצמכם · 2 דקות
ניסוי של שתי דקות: כתבו בצ'אט "אני מתכנן טיול לחיפה בשבת", ואז שאלו "לאיזו עיר ובאיזה יום?". פתחו שיחה חדשה ושאלו שוב, בלי הפרטים. השוו; אם הכלי זכר, בדקו אם מופעל בו זיכרון בין שיחות.
מתוך מונח השבוע של Wiki-AI.
שאלות נפוצות ❓
מה קורה כשהשיחה חורגת מחלון-ההקשר?
המידע הישן ביותר בדרך-כלל נחתך ולא נכנס יותר לחישוב — המודל "שוכח" אותו, גם אם הוא נאמר קודם באותה שיחה, אלא אם המוצר מיישם מנגנון-סיכום או זיכרון נפרד.
האם חלון-הקשר גדול יותר תמיד עדיף?
לא בהכרח — הוא יקר יותר, איטי יותר, וסובל מ"ריקבון-הקשר": ביצועים שיורדים ככל שהקלט מתארך, גם כשכל המידע הרלוונטי עדיין נמצא בתוכו.
האם חלון-הקשר הגדול מייתר את הצורך ב-RAG?
לא — למסמך בודד הוא יכול להתחרות ב-RAG, אבל למאגרי-ידע גדולים באמת (אלפי מסמכים ומעלה) איחזור ממוקד עדיין עדיף בביצועים, בעלות ובמהירות.
האם המודל "זוכר" אותי משיחה לשיחה בזכות חלון-הקשר?
לא — כל שיחה חדשה מתחילה עם חלון-הקשר ריק. "זיכרון בין-שיחות" הוא תכונת-מוצר נפרדת שחלק מהשירותים מוסיפים במיוחד, לא תוצאה טבעית של גודל-החלון.