טוקן (Token)
הגדרה
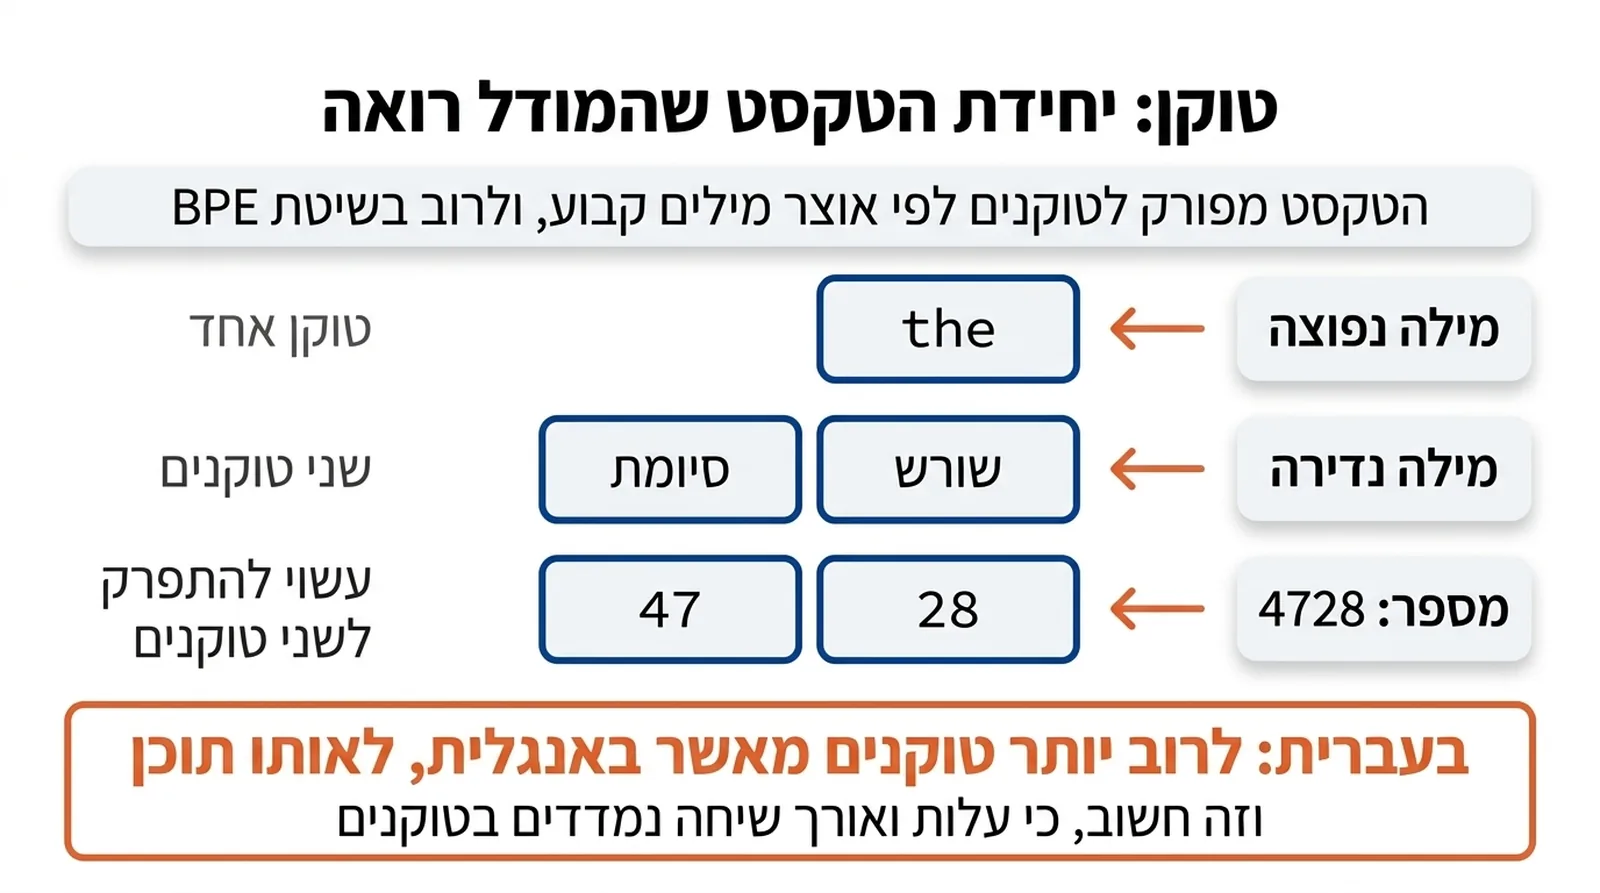
טוקן (Token) הוא יחידת הטקסט הבסיסית שמודל שפה "רואה" — לרוב חלק ממילה, לא מילה שלמה.
💡 דוגמה
המילה הנפוצה "the" היא טוקן אחד. מילה נדירה עלולה להתפרק לשני טוקנים, למשל שורש וסיומת. והמספר 4728 יכול להתפרק ל-"47" ול-"28".
מה זה טוקן, ואיך אלגוריתם BPE בונה אוצר-מילים
טוקן (Token) הוא יחידת הטקסט הבסיסית שמודל שפה גדול (LLM) "רואה" ומעבד בפועל — לרוב לא מילה שלמה, אלא חלק ממילה, סימן פיסוק, רווח, או לעיתים מילה שלמה קצרה. לפני שכל טקסט מגיע למודל, הוא עובר תהליך שנקרא טוקניזציה (Tokenization) — חלוקה שיטתית של הרצף לטוקנים בודדים לפי מילון קבוע-מראש שנקרא "אוצר-מילים" (Vocabulary), שכל טוקן בו מקבל מספר-זיהוי ייחודי. המודל עצמו, ברמה החישובית הפנימית שלו, לא "רואה" אותיות או מילים כלל — הוא מעבד אך ורק רצף של מספרים שלמים, וטוקניזציה היא בדיוק השלב שממיר טקסט אנושי לרצף-כזה ובחזרה.
השיטה הנפוצה ביותר לבניית אוצר-המילים נקראת קידוד-זוגות-בתים (Byte Pair Encoding — BPE): במקום לקבוע מראש רשימת-מילים סגורה (שהייתה נכשלת מול כל מילה חדשה או שגיאת-כתיב), האלגוריתם מתחיל מתווים בודדים ומאחד בהדרגה את הצמדים הנפוצים ביותר לטוקנים גדולים יותר, על בסיס ניתוח סטטיסטי של כמויות-ענק של טקסט. התוצאה: מילים נפוצות וקצרות (כמו "the" באנגלית, או מילות-יחס נפוצות בעברית) מקבלות טוקן שלם משלהן, בעוד מילים נדירות, מורכבות, או שגויות-כתיב מתפרקות אוטומטית לכמה טוקנים קטנים יותר — לדוגמה, מילה נדירה עלולה להתפרק לשורש ולסיומת כשני טוקנים נפרדים, גם בלי שהמודל "יודע" דקדוק במובן פורמלי. הגמישות הזו היא הסיבה שמודל שפה מסוגל להתמודד עם כמעט כל מילה שהוא נתקל בה, גם כזו שמעולם לא ראה שלמה באימון — הוא פשוט מרכיב אותה מחלקים מוכרים יותר.
גודל אוצר-המילים, ולמה עלות וחלון-הקשר נמדדים בטוקנים
גודל אוצר-המילים גדל משמעותית עם השנים. מודלים מוקדמים כמו GPT-2 (2019) השתמשו באוצר-מילים של כ-50,000 טוקנים שונים בלבד; מודלי GPT-4 ואילך של OpenAI עברו לאוצר-מילים גדול משמעותית — כ-100,000 טוקנים בקידוד cl100k_base, ומעל 200,000 טוקנים בקידוד o200k_base המשמש במודלים חדשים יותר. אוצר-מילים גדול יותר מאפשר בממוצע פחות טוקנים לכל טקסט נתון (כי יותר מילים ותת-מילים נפוצות מקבלות טוקן שלם משלהן במקום להתפרק), אבל דורש גם יותר זיכרון וחישוב בשכבת-הקלט/פלט של המודל עצמה — כך שהגדלת אוצר-המילים היא פשרה הנדסית, לא שיפור חד-משמעי חינמי.
אורך שיחה, וברוב השירותים המסחריים גם עלות השימוש, נמדדים בטוקנים ולא במילים — הבדל שנוגע ישירות לכיס של כל מי שמשלם על שימוש ב-API של מודל שפה. חלון-ההקשר (Context Window) של מודל מוגדר תמיד במונחי-טוקנים, לא מילים או תווים, ומרבית הספקים המסחריים מתמחרים לפי כמות-טוקנים שעובדה — הן בקלט והן בפלט, לרוב במחירים שונים זה מזה. הבדל-מחיר אופייני: קריאה ל-API עולה בדרך-כלל יותר עבור טוקני-פלט מאשר עבור טוקני-קלט, כי ייצור-טקסט חדש דורש חישוב-מודל מלא לכל טוקן בודד, בעוד עיבוד-קלט יכול להתבצע במקביל.
האתגר לעברית: יותר טוקנים לאותו תוכן
לדוברי עברית יש שיקול נוסף שפחות מדובר עליו מחוץ לקהילה הטכנית: מרבית מודלי-הטוקניזציה הגדולים אומנו על תמהיל-טקסט שרובו המכריע אנגלי, ואלגוריתם ה-BPE "למד" בהתאם דפוסי-אותיות ותתי-מילים שנפוצים בעיקר באנגלית. התוצאה בפועל: מילה עברית זהה במשמעותה למילה אנגלית נוטה להתפרק ליותר טוקנים ממקבילתה האנגלית — לפעמים פי שניים או שלושה יותר טוקנים לאותה כמות תוכן ממשי. יש לכך שתי השלכות מעשיות: ראשית, טקסט עברי "צורך" יותר מ"מכסת-הטוקנים" הזמינה בחלון-ההקשר מאשר אנגלית מקבילה, כך שאותו חלון-הקשר "מחזיק" בפועל פחות תוכן עברי; שנית, בשירותים המחייבים לפי-טוקן, שימוש בעברית עלול לעלות יותר לאותה כמות-מידע ממשית. הפער הזה הצטמצם עם הדורות האחרונים של מודלים ואוצרות-מילים גדולים יותר, ככל שיותר טקסט לא-אנגלי נכלל בנתוני-האימון, אבל טרם נסגר לגמרי, ומגמת-הצמצום איטית יחסית.
השפעה על חישוב אריתמטי, וההבדל בין ספקים
לטוקניזציה יש גם השלכה פחות-מוכרת על יכולות-חשבון של מודל שפה. כשמודל "רואה" מספר כמו 4728, הוא לא בהכרח מקבל אותו כארבע ספרות נפרדות — תלוי בשיטת-הטוקניזציה הספציפית, המספר עשוי להתפרק לטוקנים כמו "47" ו"28" יחד, או אפילו לטוקן אחד שלם עבור מספרים נפוצים. הפיצול הלא-עקבי הזה נחשב לאחד ההסברים המרכזיים לכך שמודלי שפה, גם המתקדמים ביותר, נוטים לטעות בחישובים אריתמטיים פשוטים-לכאורה (כמו חיבור מספרים ארוכים) בהרבה יותר קלות משהם טועים במשימות-שפה מקבילות-בקושי — הבעיה היא לא "בורות מתמטית" אלא ייצוג-פנימי לא-אחיד של הספרות עצמן. חלק מהפתרונות המעשיים שאומצו כוללים "טוקניזציה-לפי-ספרה" (חלוקת כל ספרה בודדת לטוקן נפרד, במיוחד במודלים ממוקדי-מתמטיקה) וכלים חיצוניים שמריצים חישוב מדויק במקום להסתמך על ניחוש-המודל.
השוואה בין תוצאות-טוקניזציה של ספקים שונים היא לא תמיד ישרה, כי כל חברת-AI מפתחת אוצר-מילים משלה, מותאם לתמהיל-הנתונים שעליו היא אימנה את המודלים שלה. כלי-הטוקניזציה הרשמי של OpenAI, tiktoken, פורסם כספריית-קוד-פתוח ומאפשר לכל מפתח לספור מראש כמה טוקנים תעלה שאילתה נתונה — כלי חשוב מעשית, כי הוא מאפשר תכנון-עלויות מדויק לפני שליחת בקשה בפועל, במקום להתבסס על ניחוש גס לפי ספירת-מילים. ספקים אחרים מפרסמים כלים דומים לאוצרות-המילים שלהם, אבל אין תקן אחיד בין-חברתי — אותו טקסט בדיוק עלול להתפרק למספר טוקנים שונה לגמרי אצל ספקים שונים.
טוקן כמונח מחוץ ל-AI, וטוקנים מיוחדים לשיחה מובנית
טוקן, כמונח, לא ייחודי לתחום מודלי-השפה — באבטחת-מידע וברשתות תשלומים "טוקניזציה" מתארת החלפת נתון רגיש (כמו מספר-כרטיס-אשראי) בזיהוי-חלופי חסר-משמעות, כדי לצמצם חשיפה של המידע המקורי; במטבעות-דיגיטליים "טוקן" מתאר נכס דיגיטלי על-גבי בלוקצ'יין. שלושת המובנים חולקים רעיון-משותף רופף — "יחידת-ייצוג-סמלית של משהו אחר" — אבל הם תחומי-ידע נפרדים לחלוטין מבחינה טכנית, ובהקשר של מודלי שפה, טוקן מתאר תמיד יחידת-טקסט-לעיבוד, לא נכס דיגיטלי ולא אמצעי-הגנת-פרטיות.
מעבר לטוקנים שמייצגים תוכן-טקסט רגיל, אוצר-המילים של כל מודל כולל גם "טוקנים מיוחדים" (Special Tokens) שאין להם מקבילה במילה אנושית רגילה — למשל טוקן שמסמן "סוף-הטקסט", טוקנים שמפרידים בין תפקידי-דובר בשיחה (הודעת-משתמש מול תשובת-מודל מול הוראת-מערכת), וטוקנים שמסמנים תחילת וסוף של קטע-קוד. הטוקנים המיוחדים האלה הם התשתית שמאפשרת למודל להבחין "מי אמר מה" בתוך שיחה מובנית — הם בדרך-כלל בלתי-נראים למשתמש בממשק-הצ'אט הרגיל, אבל מהותיים לתפקוד התקין של השיחה, ומחפים חלק מהמכסה הכוללת של חלון-ההקשר (Context Window) בדיוק כמו כל טוקן אחר.
המגבלה: למה מודלים מתקשים לספור אותיות
לבסוף, חשוב לזכור שהבחירה איך לחלק טקסט לטוקנים משפיעה גם על היכולת של המודל "לראות" מבנה פנימי של מילים — יכולת שיש לה מגבלות אמיתיות. משימות שדורשות התייחסות-לאותיות-בודדות בתוך מילה (כמו ספירת-כמות-אותיות מסוג מסוים, או פתרון חידות-מילים) קשות במיוחד למודלי שפה בדיוק בגלל שהם "רואים" את המילה כטוקן שלם או כמה טוקנים גדולים, לא כרצף-אותיות גלוי — פער בין האופן שבו בני-אדם קוראים טקסט (אות-אחר-אות ברמה הכי-בסיסית) לבין האופן שבו מודל-שפה מעבד אותו (יחידות-תת-מילה גדולות יותר), שמסביר חלק ניכר מהתקלות-שנראות-מוזרות שמודלים עלולים לעשות במשימות שנראות טריוויאליות לאדם. הדוגמה המוכרת ביותר לפער הזה, שהפכה סוג של "בדיקת-כשל" פופולרית ברשתות-החברתיות מאז 2024: מודלים רבים מתקשים לענות נכון על שאלה כמו "כמה פעמים מופיעה האות ר׳ במילה 'ארוחה'", כי הם לא "רואים" את המילה כרצף-אותיות בודדות אלא כטוקן-שלם או כמה-טוקנים-גדולים — בדיוק כפי שאדם שמסתכל על תמונה של מילה שלמה, ולא על כל אות בנפרד, עלול גם הוא לפספס ספירה מדויקת בלי לעצור ולבדוק אות-אחר-אות.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
🎯 נסו בעצמכם · 2 דקות
בשתי דקות, הדביקו בצ'אטבוט משפט קצר ובקשו המחשה לחלוקה אפשרית לחלקי מילים. בקשו להבחין בין ההמחשה לבין חלוקת הטוקנים האמיתית של המודל.
מתוך מונח השבוע של Wiki-AI.
שאלות נפוצות ❓
כמה טוקנים יש במילה עברית ממוצעת?
תלוי במילה ובמודל, אך לרוב יותר מבמילה אנגלית מקבילה — לעיתים פי שניים או שלושה, בגלל האופן שבו רוב אוצרות-המילים אומנו בעיקר על טקסט אנגלי.
למה עלות שימוש ב-AI נמדדת בטוקנים ולא במילים?
כי המודל בפועל מעבד טוקנים, לא מילים — טוקן הוא היחידה החישובית האמיתית שדורשת משאבים, בעוד "מילה" היא מושג לשוני שלא תמיד תואם ליחידת-העיבוד בפועל.
האם אפשר לספור טוקנים מראש לפני שליחת שאילתה?
כן — כלים כמו tiktoken, הספרייה הרשמית של OpenAI, מאפשרים לספור בדיוק כמה טוקנים טקסט נתון יעלה, לפני שליחתו בפועל.
למה מודלי AI טועים לפעמים בחישובים פשוטים?
חלק גדול מהבעיה קשור לאופן שבו מספרים מפוצלים לטוקנים — פיצול לא-עקבי של ספרות מקשה על המודל "לראות" את המבנה המספרי המדויק.