טוקניזציה (Tokenization)
הגדרה
טוקניזציה היא פירוק טקסט ליחידות קטנות (טוקנים) שמודל שפה מסוגל לעבד — מילים שלמות, חלקי-מילים, או תווים בודדים, תלוי בשיטה.
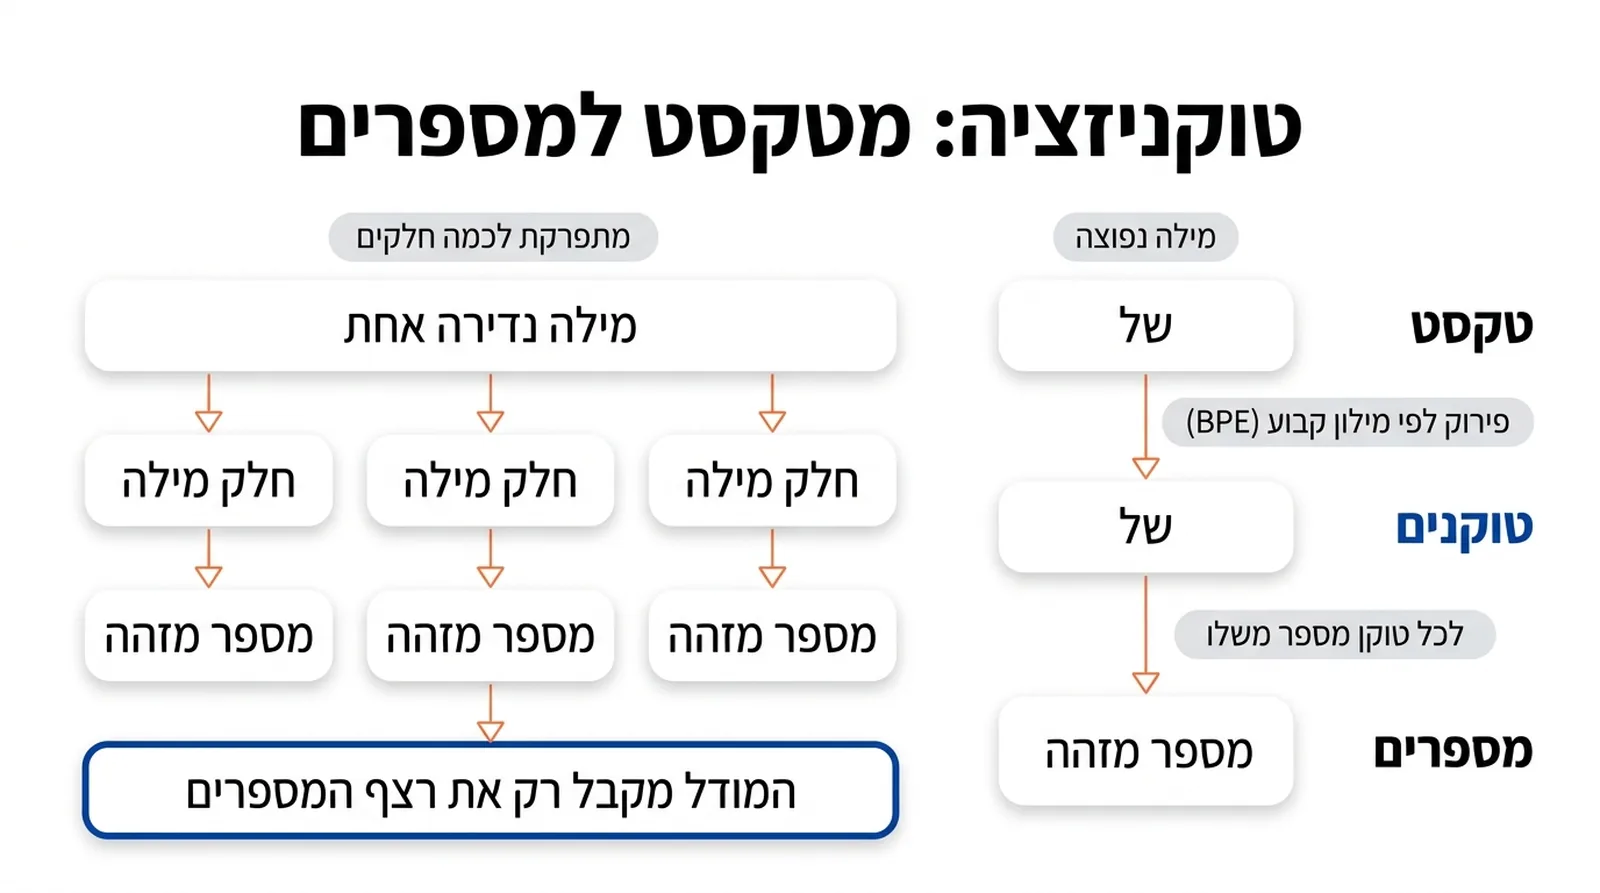
מודל שפה לא "קורא" טקסט כמו בן-אדם — הוא מקבל רצף מספרים. טוקניזציה היא השלב הראשון שממיר טקסט לרצף כזה, לפי מילון-טוקנים קבוע שהמודל אומן עליו.
השיטה הנפוצה ביותר כיום, קידוד-זוגות-בתים (ראו הערך BPE), פותחה במקור עבור תרגום-מכונה והוצגה במאמר מ-2016 — ואומצה מאז, בגרסאות מעט שונות, על-ידי כמעט כל מודלי השפה הגדולים, כולל ChatGPT, Claude ו-Gemini.
שיטות כאלה מפרקות מילים נדירות לחלקים קטנים יותר וחוזרים-על-עצמם, כדי לאזן בין גודל-מילון סביר ליכולת לייצג כל מילה אפשרית — גם כזו שהמודל מעולם לא ראה שלמה. בפועל, מילה נדירה עשויה להתפרק לכמה טוקנים נפרדים, בעוד מילה נפוצה כמו "של" או "the" תישאר לרוב טוקן שלם אחד — התלות היא ישירות בתדירות המילה בטקסט-האימון, לא במשמעות הלשונית שלה.
לא כל שפה מתפרקת בקלות לפי רווחים בין מילים: שפות הכתובות ברצף רציף בלי הפרדות ברורות (כמו סינית או תאית) מציבות אתגר-טוקניזציה שונה לגמרי, שדורש שיטות זיהוי-גבולות-מילים ייעודיות במקום פיצול פשוט לפי רווח. זו הסיבה שאיכות הטוקניזציה משתנה בין שפות — מילון-טוקנים שאומן בעיקר על טקסט אנגלי לא בהכרח מפרק שפות אחרות באותה יעילות, מה שיכול להשפיע גם על מהירות ועלות עיבוד טקסט בשפות שאינן אנגלית.
תובנה מעשית: רוב ממשקי-התכנות (API) של ספקי-מודלים מתמחרים שימוש לפי מספר-הטוקנים, לא לפי מספר-המילים או התווים — כך שאותה כמות טקסט בפועל יכולה לעלות סכומים שונים, תלוי בשפה ובאיכות-ההתאמה של מילון-הטוקנים לאותה שפה. זו הסיבה שמפתחים שבונים מוצרים רב-לשוניים בודקים לעיתים במפורש כמה טוקנים "עולה" טקסט זהה בשפות שונות, לא רק את איכות התרגום או ההבנה של המודל.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות