BPE (קידוד-זוגות-בתים)
הגדרה
BPE הוא אלגוריתם הטוקניזציה הנפוץ ביותר במודלי שפה מודרניים — בונה מילון-טוקנים על ידי מיזוג הדרגתי של הזוגות הנפוצים ביותר של תווים או חלקי-מילים.
מה זה טוקניזציה, ולמה היא נחוצה
BPE (קידוד-זוגות-בתים) הוא האלגוריתם הנפוץ ביותר לטוקניזציה — פירוק טקסט חופשי למקטעים קבועים-מראש (טוקנים) שמודל שפה יכול לעבד. מודל AI אינו קורא טקסט כמילים; הוא מקבל רצף מספרים, וכל טוקן הוא ערך במילון סגור וקבוע-מראש.
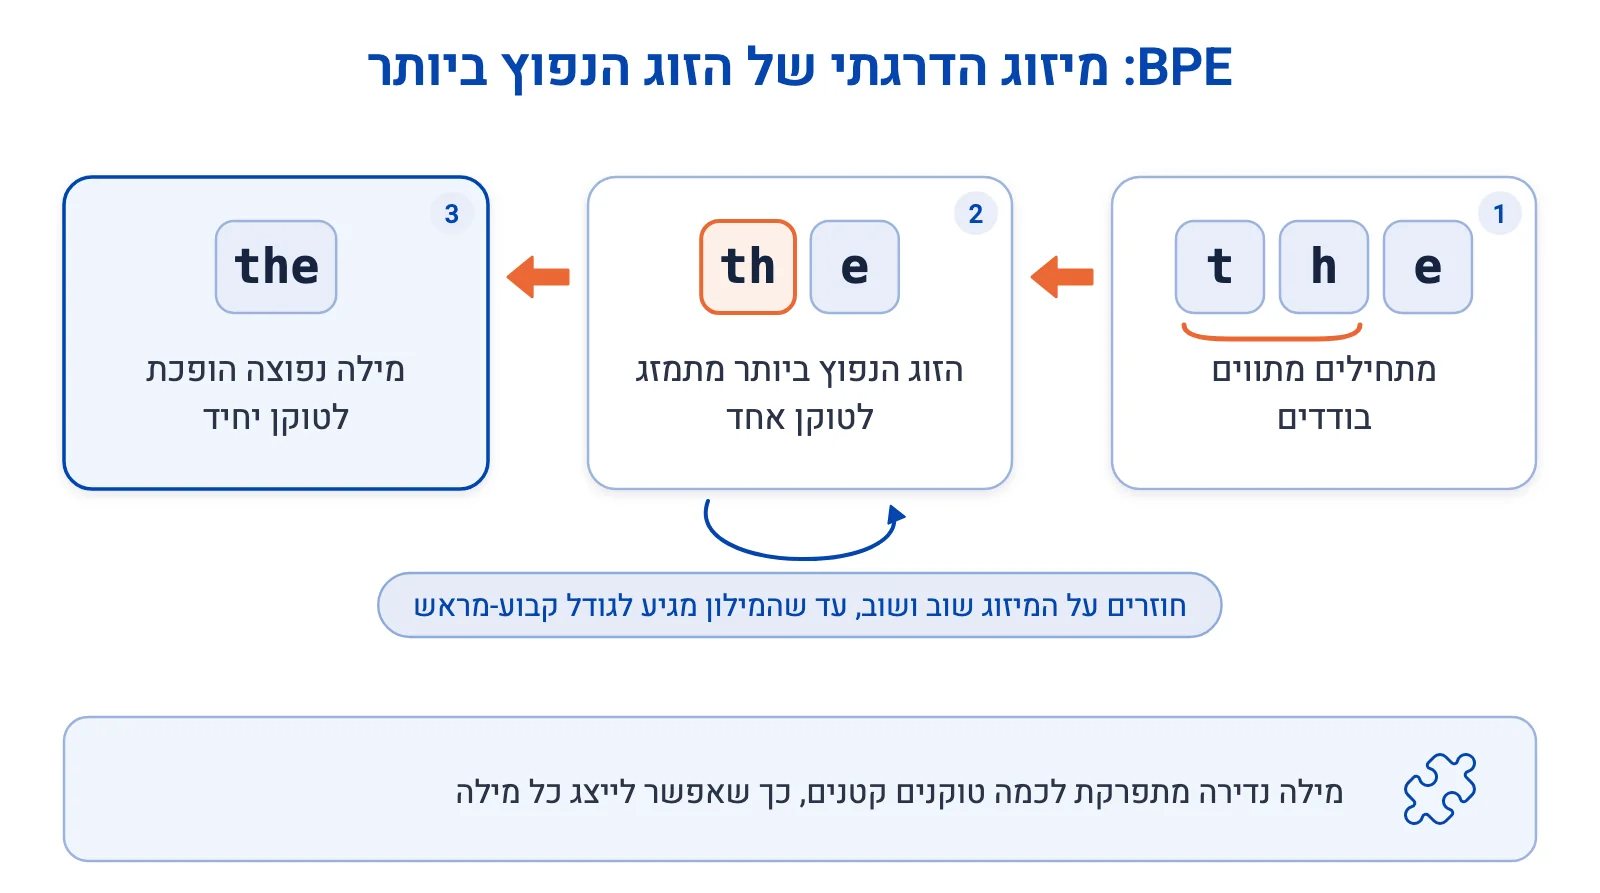
הבעיה שהוא פותר: מילים נפוצות (כמו "the") הופכות לטוקן יחיד, בעוד מילים נדירות מתפרקות לכמה טוקנים קטנים יותר — כך המודל יכול לייצג כל מילה אפשרית, גם כזו שלא ראה מעולם באימון, בלי צורך במילון אינסופי או מנגנון גיבוי מיוחד למילים לא-מוכרות.
האלגוריתם: מיזוג הדרגתי של זוגות-תווים
השיטה, המכונה קידוד-זוגות-בתים (BPE — Byte Pair Encoding), מתחילה מתווים בודדים, וממזגת שוב ושוב את הזוג הנפוץ ביותר שמופיע יחד בטקסט-האימון (למשל "t"+"h" הופכים ל-"th"), עד שנוצר מילון בגודל קבוע-מראש שמכיל גם תווים בודדים, גם חלקי-מילים נפוצים, וגם מילים שלמות נפוצות.
משורשים בדחיסת-נתונים (1994) לעיבוד-שפה (2016)
האלגוריתם המקורי תואר כבר ב-1994 על ידי פיליפ גייג' (Philip Gage), כשיטת דחיסת-נתונים כללית ולא-קשורה בכלל ל-AI — כמעט 20 שנה לפני שהותאם לראשונה למידול-שפה, במאמר מ-2016 שהציג אותו ככלי לטיפול במילים נדירות בתרגום-מכונה. מאמר-המקור, "Neural Machine Translation of Rare Words with Subword Units", מאת ריקו זנריך, בארי הדואו ואלכסנדרה בירץ', הראה שהשיטה משפרת תרגום-מכונה עצבי במשימות מאנגלית לגרמנית ומאנגלית לרוסית, ואומצה מאז כמעט אוניברסלית בכלים לעיבוד-שפה.
מילון GPT-4 מול Jurassic-1 הישראלי
בפועל, מילון-הטוקנים של GPT-4 (מודל של OpenAI) מכיל כ-100,258 טוקנים — כ-100,000 שנוצרו מתהליך ה-BPE, ועוד 258 טוקנים מיוחדים לתפקידים טכניים (כמו סימון תחילת או סוף של קטע-טקסט).
לשם השוואה, מילון-הטוקנים של Jurassic-1 — מודל-השפה שפיתחה AI21 Labs, חברה ישראלית מתל אביב שנוסדה ב-2017 — כלל למעלה מ-250,000 טוקנים, גדול משמעותית ממילון GPT-4, בחירה שנועדה לשפר את יעילות-הטוקניזציה במגוון רחב יותר של שפות.
Byte-Level BPE ולמה BPE נשאר ברירת-המחדל
גרסה מתקדמת יותר, קידוד-זוגות-בתים ברמת-בתים (Byte-Level BPE), מבטיחה שכל טקסט אפשרי בקידוד (UTF-8 — Unicode Transformation Format) — כולל אימוג'ים, סימנים נדירים, וכל שפה אנושית — ניתן לקידוד תמיד, גם בלי שהמודל ראה את הסימן הספציפי הזה מעולם באימון.
שיטות חלופיות ומתחרות התפתחו גם הן — למשל טוקניזציה מבוססת-מודל-שפה-יוניגרמי (Unigram Language Model Tokenization), המשמשת בכמה מודלים כמו T5 ומודלי Google נוספים — אך BPE, ובמיוחד הגרסה ברמת-הבתים שלו, נותרה ברירת-המחדל הנפוצה ביותר בתעשייה נכון ל-2026, בזכות שילוב פשוט יחסית של יעילות-חישוב ואוניברסליות בין שפות ותחומים.
הבחירה במילון-טוקנים ספציפי היא החלטה שמתקבלת פעם אחת, לפני האימון הראשי כולו — שינוי מאוחר-יותר של מילון-הטוקנים דורש בפועל אימון-מחדש כמעט מלא של המודל, ולא תיקון קל.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
שאלות נפוצות ❓
מה עושה אלגוריתם BPE בפועל?
מתחיל מתווים בודדים וממזג שוב ושוב את הזוג הנפוץ ביותר שמופיע יחד בטקסט-האימון, עד שנוצר מילון-טוקנים בגודל קבוע-מראש — שמכיל גם תווים בודדים, גם חלקי-מילים נפוצים, וגם מילים שלמות נפוצות.
מי המציא אותו ומתי, ולמה לא ל-AI במקור?
האלגוריתם תואר ב-1994 על ידי פיליפ גייג', כשיטת דחיסת-נתונים כללית — לא קשורה ל-AI כלל. רק ב-2016, כמעט 20 שנה מאוחר יותר, הותאם לראשונה למידול-שפה, במאמר שהציג אותו ככלי לטיפול במילים נדירות בתרגום-מכונה.
למה מילון-הטוקנים של Jurassic-1 גדול יותר מזה של GPT-4?
Jurassic-1 של AI21 Labs הישראלית כלל למעלה מ-250,000 טוקנים, מול כ-100,258 ב-GPT-4 — בחירה שנועדה לשפר את יעילות-הטוקניזציה במגוון רחב יותר של שפות.
למה קשה לשנות מילון-טוקנים אחרי שהאימון התחיל?
הבחירה במילון-טוקנים מתקבלת פעם אחת, לפני האימון הראשי כולו. שינוי מאוחר-יותר דורש בפועל אימון-מחדש כמעט מלא של המודל, ולא תיקון קל.