MMLU-Pro — אמת-מידה מוקשחת ל-MMLU; 10 אפשרויות-תשובה במקום 4
הגדרה
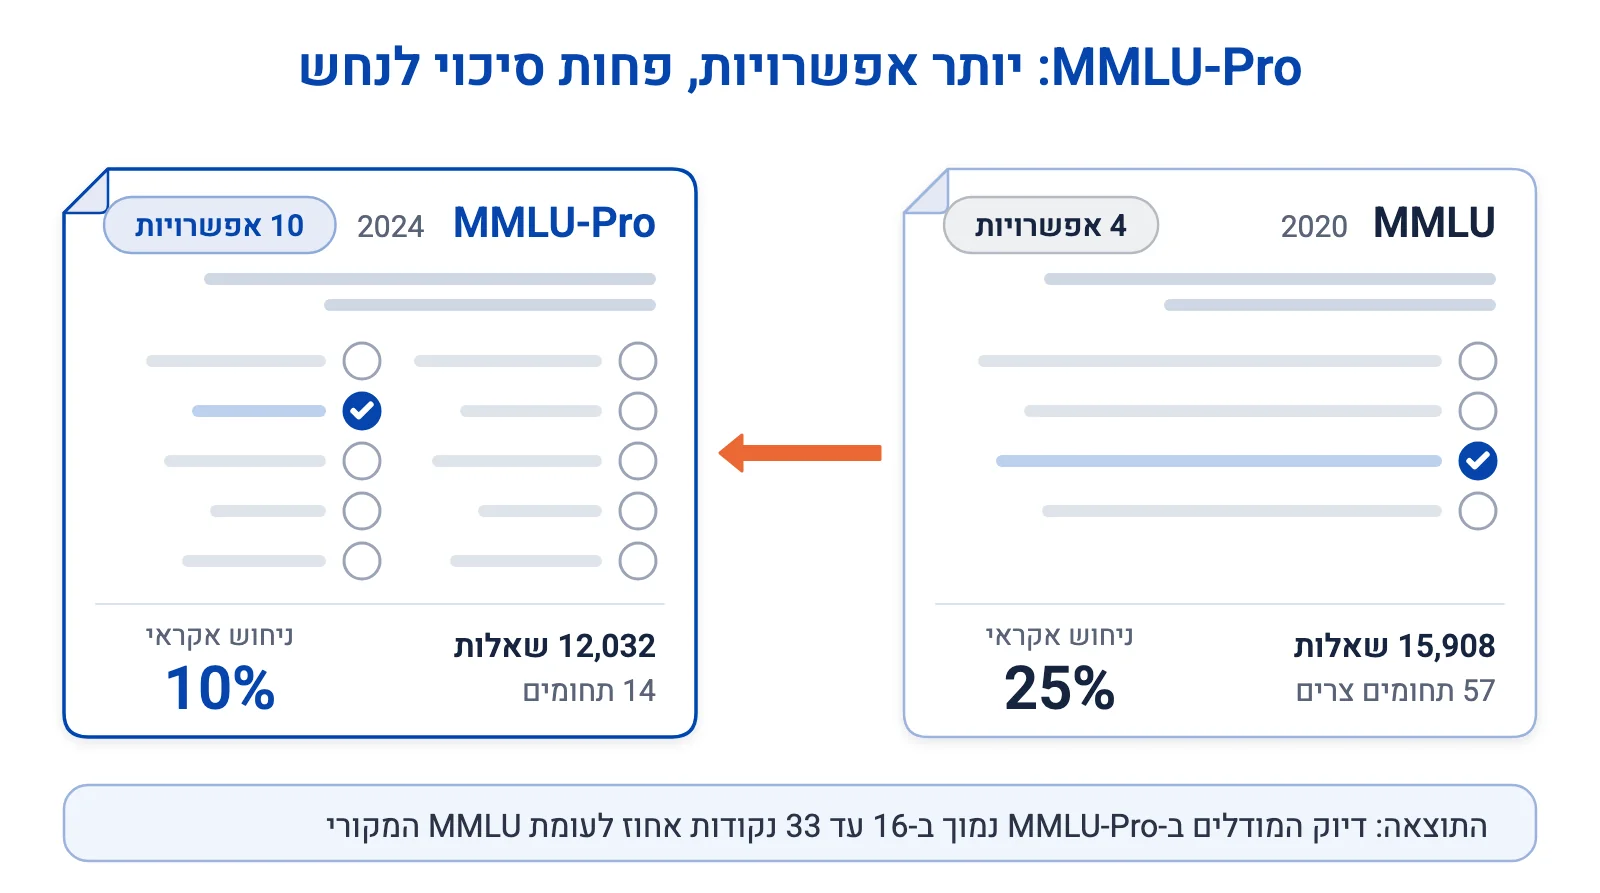
MMLU-Pro היא גרסה מחמירה יותר של MMLU, שפרסמה TIGER-Lab מאוניברסיטת ווטרלו ביוני 2024 — 12,032 שאלות על 14 תחומים, עם 10 אפשרויות-תשובה במקום ארבע, שמורידה ציוני-מודלים ב-16 עד 33 נקודות-אחוז.
התגובה לרוויה: MMLU-Pro
MMLU-Pro היא גרסה מוקשחת של MMLU, שפרסמה TIGER-Lab — מעבדת-מחקר באוניברסיטת ווטרלו, בהובלת וונהו צ'ן ובכתיבתו הראשית של יובו וואנג, סטודנט לדוקטורט באותה מעבדה — ביוני 2024, במאמר שהוצג מאוחר יותר ב-NeurIPS 2024. הרקע ידוע: עד 2024 מודלים מובילים כבר הגיעו לציונים גבוהים וקרובים זה לזה ב-MMLU המקורי, מ-2020, סימן לרוויה שקשה להבחין בעזרתה בין יכולות המודלים החדשים. MMLU-Pro לא נועד להחליף את המושג "MMLU", אלא לתת לו המשך שאפשר עדיין למדוד איתו הבדלים אמיתיים בין מודלים שהתקרבו כולם לתקרה. תגובה אחרת לאותה רוויה היא הבחינה האחרונה של האנושות (Humanity's Last Exam), מבחן של 2,500 שאלות ברמת מומחה שפרסמו ב-2025 המרכז לבטיחות AI ו-Scale AI.
מ-4 ברירות ל-10, מ-57 תחומים ל-14
המבחן כולל 12,032 שאלות, שנאספו וסוננו ממבחנים אקדמיים וספרי-לימוד על פני 14 תחומים — ביולוגיה, עסקים, כימיה, מדעי-המחשב, כלכלה, הנדסה, בריאות, היסטוריה, משפטים, מתמטיקה, פילוסופיה, פיזיקה, פסיכולוגיה, ותחום "אחר" שאוסף נושאים שלא נכנסים לקטגוריה ממוקדת — לעומת 57 התחומים הצרים והממוקדים-יותר של MMLU המקורי. לכל שאלה 10 אפשרויות-תשובה במקום ארבע ב-MMLU המקורי — שינוי שמוריד את הסיכוי להצליח בניחוש אקראי מ-25 אחוזים ל-10 אחוזים בלבד, ומקשה משמעותית לעקוף את השאלה בלי הבנה אמיתית, גם למודל שרק "מנחש חכם" בין האפשרויות באמצעות תבניות-שפה סטטיסטיות ולא ידע אמיתי.
מה עוד השתנה: לא רק יותר אפשרויות
מעבר להרחבת האפשרויות, TIGER-Lab גם סיננה מתוך MMLU המקורי שאלות טריוויאליות ורועשות — כאלה שכל המודלים עונים עליהן נכון, ולכן אינן תורמות מידע על ההבדלים ביניהם — ושילבה לצד שאלות שנשמרו שאלות חדשות שדורשות הנמקה מרובת-שלבים ולא רק שליפת-עובדה בודדת. התוצאה נמדדת: MMLU-Pro מוריד את דיוק המודלים ב-16 עד 33 נקודות-אחוז לעומת MMLU המקורי — טווח רחב, שמעיד על כך שחלק מהמודלים נשענו על MMLU יותר משנדמה, ושחלק מהציון הגבוה שלהם במבחן הישן היה תוצאה של רוויה ולא של יכולת אמיתית עמוקה יותר.
תוצאה נלווית: פחות רגישות לניסוח
מדד נוסף שדיווח עליו המאמר הוא יציבות: רגישות ציוני-המודלים לשינוי בניסוח השאלה — כלומר כמה הציון קופץ כשמנסחים בדיוק אותה שאלה קצת אחרת, מבדיקה שהריצה 24 סגנונות-ניסוח שונים על אותן שאלות — ירדה מ-4 עד 5 אחוזים ב-MMLU לכ-2 אחוזים בלבד ב-MMLU-Pro. המשמעות המעשית: שני מעבדות-מחקר ששתיהן בודקות את אותו מודל, בניסוח קצת שונה של השאלות, צפויות לקבל תוצאות קרובות זו לזו הרבה יותר ב-MMLU-Pro מאשר ב-MMLU המקורי — כלומר יותר אפשר לסמוך על השוואה בין דוחות שונים. בנוסף, מודלים שהשתמשו בשרשור-מחשבה (Chain of Thought) הגיעו לביצועים טובים יותר מתשובה ישירה על MMLU-Pro — בניגוד ל-MMLU המקורי, שם שרשור-מחשבה לא תרם באותה מידה, סימן לכך שהשאלות החדשות דורשות הנמקה בפועל ולא רק שליפת-ידע מהיר.
מי הוביל בהשקה
עם השקת המבחן, המודלים המובילים על-פי לוח-התוצאות הרשמי היו Claude 3.5 Sonnet (76.12 אחוזים), GPT-4o (72.55 אחוזים), Gemini 1.5 Pro (69.03 אחוזים), Claude 3 Opus (68.45 אחוזים) ו-GPT-4 Turbo (63.71 אחוזים) — טווח שמפזר את המודלים לאורך הלוח, בניגוד למרחק הצפוף שאפיין את MMLU המקורי באותה תקופה, שבו GPT-4 (86.4 אחוזים) ו-Gemini Ultra (90.0 אחוזים, בשיטת-הערכה שונה) כבר נגעו ברף בוחני-האנוש-המומחים. כלומר בדיוק מה שהמבחן נועד להשיג: פיזור שאפשר לקרוא ממנו דירוג משמעותי, לא אשכול של ציונים כמעט-זהים.
ההבדל מהמושג הכללי "אמת-מידה"
כמו HumanEval ו-MMLU עצמו, גם MMLU-Pro הוא מופע ספציפי ומתוארך של המושג הכללי "אמת-מידה" (Benchmark) — לא הגדרה חדשה של מה זו אמת-מידה, אלא תגובה קונקרטית לבעיה קונקרטית שהתגלתה במבחן קודם. הערך הזה עוסק במה ש-MMLU-Pro עצמו מודד ובמה שהשתנה בו לעומת המבחן שקדם לו; ההסבר הכללי לשאלה למה בכלל יש אמות-מידה, ולבעיות המובנות שלהן כמו זיהום-נתונים, מרוכז בערך הנפרד באתר על אמות-מידה בכלל. הקוד ומאגר-הנתונים של MMLU-Pro פורסמו בקוד-פתוח, כך שכל קבוצת-מחקר יכולה להריץ אותו על מודל חדש בעצמה, בלי לחכות שהמפרסם המקורי יעדכן לוח-תוצאות.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
| מספר שאלות | אפשרויות-תשובה | ניחוש אקראי | רגישות לניסוח | |
|---|---|---|---|---|
| MMLU (2020) | 15,908 | 4 | 25% | 4–5% |
| MMLU-Pro (2024) | 12,032 | 10 | 10% | כ-2% |
שאלות נפוצות ❓
מי פרסם את MMLU-Pro, ומתי?
TIGER-Lab, מעבדת-מחקר באוניברסיטת ווטרלו, פרסמה את MMLU-Pro ביוני 2024, במאמר שהוצג מאוחר יותר ב-NeurIPS 2024.
מה בדיוק השתנה לעומת MMLU המקורי?
מספר האפשרויות לכל שאלה עלה מארבע לעשר (מה שמוריד את סיכוי-הניחוש-האקראי מ-25% ל-10%), שאלות טריוויאליות סוננו החוצה, ונוספו שאלות חדשות הדורשות הנמקה, כך שהמבחן כולו מונה 12,032 שאלות על פני 14 תחומים, במקום 57 התחומים המקוריים.
כמה ציוני-המודלים ירדו כשעברו ל-MMLU-Pro?
בין 16 ל-33 נקודות-אחוז, תלוי במודל — טווח רחב שממחיש כמה מהציון הגבוה ב-MMLU המקורי נבע מרוויה ולא מיכולת אמיתית.
האם MMLU-Pro רגיש פחות לניסוח השאלה?
כן. רגישות-הציון לניסוח ירדה מ-4 עד 5 אחוזים ב-MMLU לכ-2 אחוזים ב-MMLU-Pro — כלומר תוצאה יציבה יותר ופחות תלויה באופן שבו מנסחים את השאלה.
האם שרשור-מחשבה (Chain of Thought) עוזר יותר ב-MMLU-Pro?
כן, בניגוד ל-MMLU המקורי — מודלים שהשתמשו בהנמקה מפורשת הגיעו לציונים גבוהים יותר מתשובה ישירה, סימן לכך שהשאלות דורשות הנמקה בפועל.