Scaling Laws (חוקי-קנה-מידה)
הגדרה
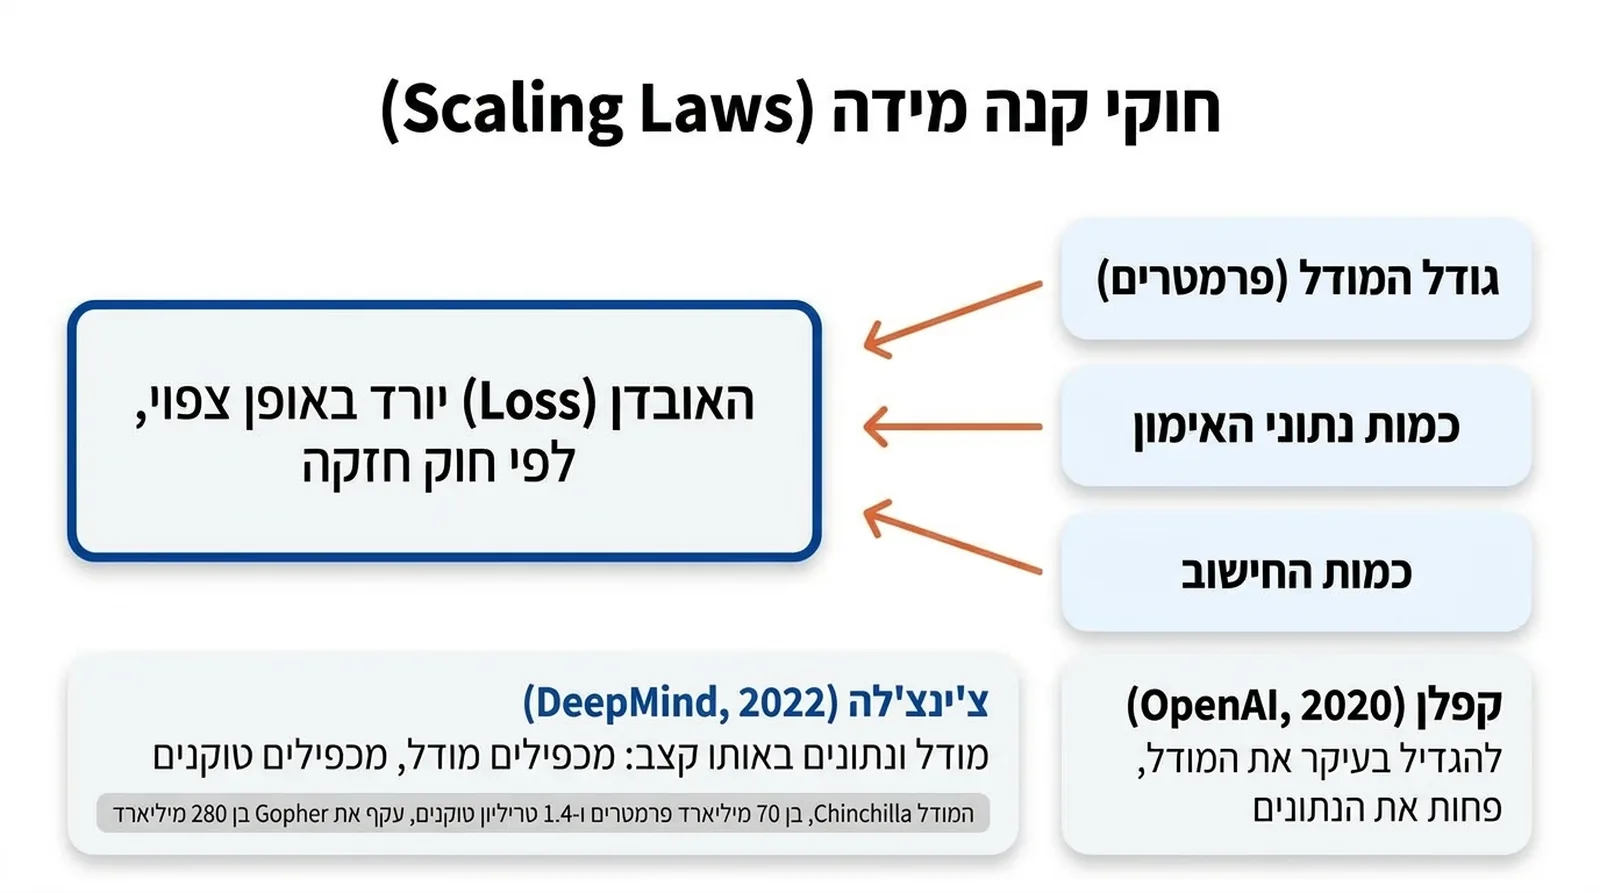
חוקי-קנה-מידה (Scaling Laws) הם קשרים אמפיריים שמתארים איך ביצועי מודל-שפה משתפרים בצורה צפויה עם גידול בגודל-המודל, בכמות נתוני-האימון ובחישוב — ומחלוקת מרכזית בתחום, בין קפלן (2020) לצ'ינצ'ילה/הופמן (2022), נסבה סביב היחס האופטימלי ביניהם.
💡 דוגמה
ככל שמגדילים את המודל, את כמות הטקסט ואת כוח המחשוב, התוצאות משתפרות בצורה צפויה. לכן החברות בונות מודלים גדולים יותר ויותר.
מהם חוקי-קנה-מידה, ולמה זה חשוב
חוקי-קנה-מידה (Scaling Laws) הם קשרים אמפיריים בין שלושה משתנים שמעצבים כל תהליך-אימון של מודל-שפה גדול: גודל המודל (מספר הפרמטרים), כמות נתוני-האימון, וכמות החישוב שהושקעה. המחקר שקבע את המונח, "Scaling Laws for Neural Language Models" מבית OpenAI (ינואר 2020, בהובלת ג'רד קפלן — Jared Kaplan), מצא ש"האובדן [Loss — מידת-הטעות הממוצעת של המודל] משתנה כחוק-חזקה עם גודל-המודל, גודל-מערך-הנתונים וכמות-החישוב המושקעת באימון, כאשר חלק מהמגמות משתרעות על פני יותר משבעה סדרי-גודל". הממצא הזה הפך את תכנון-אימון-המודלים מניסוי-וטעייה יקר לכלי-תחזית: אפשר להעריך מראש כמה ביצועים לצפות ממודל בגודל נתון, לפני שמשקיעים בו את משאבי-החישוב היקרים.
קפלן ועמיתיו, 2020: מודלים ענקיים, נתונים צנועים יחסית
מסקנתו המעשית של מאמר קפלן הייתה חדה: "מודלים גדולים יעילים משמעותית יותר מבחינת-דוגמאות, כך שאימון יעיל-חישובית-אופטימלית כולל אימון מודלים גדולים-מאוד על כמות נתונים צנועה יחסית, ועצירה משמעותית לפני התכנסות מלאה". במונחי-הנוסחה שהציעו: כאשר תקציב-חישוב נתון (C) גדל, גודל-המודל האופטימלי גדל בערך לפי C בחזקת 0.73, וכמות-הנתונים לפי C בחזקת 0.27 בלבד — כלומר גודל-המודל אמור לגדול הרבה יותר מהר מכמות-הנתונים. ההנחיה הזו הנחתה בפועל את תכנון מודלים כמו GPT-3 (175 מיליארד פרמטרים), שהמשיכו את ההיגיון הזה: ככל שהמודל גדול יותר, כך ייטב, גם אם כמות-הנתונים לא גדלה באותו קצב.
Chinchilla, 2022: היחס האמיתי — שווה בשווה
שנתיים מאוחר יותר, מאמר "Training Compute-Optimal Large Language Models" מבית Google DeepMind (מרץ 2022, בהובלת ג'ורדן הופמן — Jordan Hoffmann) אימן למעלה מ-400 מודלים בגדלים ובכמויות-נתונים שונות כדי לבדוק את הממצא מחדש, והגיע למסקנה הפוכה: גודל-המודל וכמות-הנתונים צריכים לגדול באותו הקצב בדיוק — "עבור כל הכפלה של גודל-המודל, יש להכפיל גם את כמות-טוקני-האימון". ההדגמה המעשית לכך היא המודל Chinchilla עצמו (ראו הערך הנפרד chinchilla) — 70 מיליארד פרמטרים בלבד, שאומן על 1.4 טריליון טוקנים, ועקף באופן עקבי ומובהק מודלים גדולים ממנו פי-כמה, כולל Gopher (280 מיליארד פרמטרים) ואף GPT-3 (175 מיליארד). לפי חוקי-Chinchilla, רוב מודלי-הדגל שקדמו לו היו, במילות המאמר, "תת-מאומנים באופן משמעותי" — גדולים מדי ביחס לכמות הנתונים שראו.
למה שני המחקרים סתרו זה את זה
המחלוקת בין שני חוקי-קנה-המידה אינה רק תוצאה של נתונים שונים, אלא נבעה בעיקר משיטה: לפי ניתוחים מאוחרים יותר, קפלן ועמיתיו לא ספרו את הפרמטרים בשכבת-ההטמעה (Embedding Layer) של המודל — מה שמטה את המקדמים כלפי-מעלה במיוחד במודלים קטנים — ובחנו טווח-גדלים קטן יותר ממה שקבוצת-Chinchilla בדקה מאוחר יותר. בנוסף, לוח-החימום (Warmup Schedule) ששימש את קפלן היה ארוך מדי עבור מודלים קטנים, מה שגרם להם להיראות פחות יעילים ממה שהם באמת, וההיפר-פרמטרים לא כוונו במלואם. הפער הזה ממחיש עיקרון חשוב: חוק-קנה-מידה תקף בגבולות התנאים שבהם נמדד, לא כאמת מתמטית מוחלטת ובלתי-תלויה בשיטת-המדידה.
ההשפעה על התעשייה, והגבול של החוקים
מאז 2022, "Chinchilla-optimal" הפך לנקודת-ייחוס סטנדרטית בתכנון-אימון: מודלים כמו LLaMA של Meta ו-PaLM 2 של Google מזכירים אותו במפורש בהשוואה למודלי-הענק שקדמו לו. חוקי קנה-המידה גם עומדים בבסיס הוויכוח על יכולות מתהוות (Emergent Abilities) — עד כמה אפשר לחזות מראש מתי מודל "יקפוץ" ביכולת חדשה — ומספקים ביסוס אמפירי-כמותי לטענה האיכותית של "הלקח המר" (The Bitter Lesson) של ריצ'רד סאטון: ששיטות כלליות שמנצלות עוד ועוד חישוב מנצחות בטווח הארוך הנדסת-ידע ספציפית-לתחום. עם זאת, החוקים הם אקסטרפולציה אמפירית, לא חוק-טבע מובטח — הם מניחים המשך זמינות של נתוני-אימון איכותיים בכמויות גדלות, הנחה שכבר נתקלת במגבלות בפועל ככל שספריית-הטקסט האנושי-הזמין מתקרבת למיצוי.
מעבר ל-Chinchilla: כשעלות-ההרצה חשובה יותר מעלות-האימון
היחס האופטימלי של Chinchilla מתעלם במכוון מגורם אחד: עלות-ההרצה (Inference) של המודל אחרי האימון, על-פני מיליוני שאילתות-משתמשים בפועל. מאמר "Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws" (דצמבר 2023, הובלת ניקיל סרדנה — Nikhil Sardana) הראה שכאשר צפוי ביקוש-הרצה גדול, כדאי לאמן מודל קטן-יותר על נתונים רבים-הרבה-יותר מהיחס-האופטימלי של Chinchilla — כלומר "לאמן מודלים קטנים-יותר ולמשך-זמן-ארוך-יותר מהיחס האופטימלי של Chinchilla". Meta יישמה בפועל עיקרון דומה במודל LLaMA 3: לפי הבלוג הרשמי שלה, "הן המודל בן 8 מיליארד הפרמטרים והן המודל בן 70 מיליארד המשיכו להשתפר בצורה לוגריתמית-ליניארית גם אחרי אימון על עד 15 טריליון טוקנים" — עד כשני סדרי-גודל יותר מהיחס-הכמותי ש-Chinchilla היה ממליץ עליו עבור מודל בגודל כזה. כלומר: חוקי-קנה-המידה עדיין תקפים ככלי-תחזית, אבל היחס ה"אופטימלי" עצמו תלוי-מטרה — אופטימלי-לאימון אינו זהה לאופטימלי-לפריסה בקנה-מידה עולמי.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
| Kaplan et al., 2020 | Hoffmann et al. (Chinchilla), 2022 | |
|---|---|---|
| היחס המומלץ בין גודל-מודל לנתוני-אימון | גודל-המודל גדל הרבה יותר מהר מהנתונים (N∝C^0.73, D∝C^0.27) | שני הגורמים גדלים באותו קצב (N∝C^0.5, D∝C^0.5) |
| ההמלצה המעשית | מודל ענק, פחות נתונים, לעצור לפני התכנסות מלאה | מודל קטן-יותר יחסית, הרבה יותר נתונים, עד התכנסות |
| מודל-דוגמה שיושם לפי הכלל | GPT-3 (175 מיליארד פרמטרים) | Chinchilla (70 מיליארד פרמטרים, 1.4 טריליון טוקנים) |
שאלות נפוצות ❓
מה ההבדל בין חוקי-קנה-המידה לבין Chinchilla?
Chinchilla הוא מודל-שפה ספציפי מ-2022 שהדגים בפועל את חוק-קנה-המידה שקבוצת Hoffmann גילתה; חוקי-קנה-המידה עצמם הם התופעה הכללית, לא מודל מסוים.
האם קפלן טעה?
לא בדיוק — התוצאות שלו היו נכונות בתנאי-הניסוי שבהם נמדדו, אבל כללו הטיות מתודולוגיות (ספירת-פרמטרים, לוח-חימום) שהובילו למסקנה שגויה לגבי היחס האופטימלי.
האם אפשר להגדיל מודל לנצח לפי חוקי-קנה-המידה?
לא בפועל — הגידול מוגבל בכמות נתוני-האימון האיכותיים הזמינים ובעלות-החישוב, ושני הגורמים האלה כבר מתחילים להיות צוואר-בקבוק אמיתי.
מה הקשר ליכולות מתהוות?
חלק מהוויכוח על יכולות מתהוות נסוב סביב השאלה אם חוקי-קנה-המידה — שמנבאים שיפור הדרגתי וחלק — מתיישבים עם דיווחים על קפיצות-יכולת פתאומיות, או שהקפיצות הן תוצר-לוואי של אופן-המדידה בלבד.
האם יש רק יחס-אופטימלי אחד בין גודל-מודל לנתונים?
לא — Chinchilla אופטימלי לעלות-אימון בלבד; כשצפוי ביקוש-הרצה גדול (כמו במודל שמופעל על-ידי מיליוני משתמשים), משתלם לאמן מודל קטן-יותר על הרבה יותר נתונים ממה שChinchilla היה ממליץ, בדיוק מה שMeta עשתה ב-LLaMA 3.