The Bitter Lesson (הלקח המר)
הגדרה
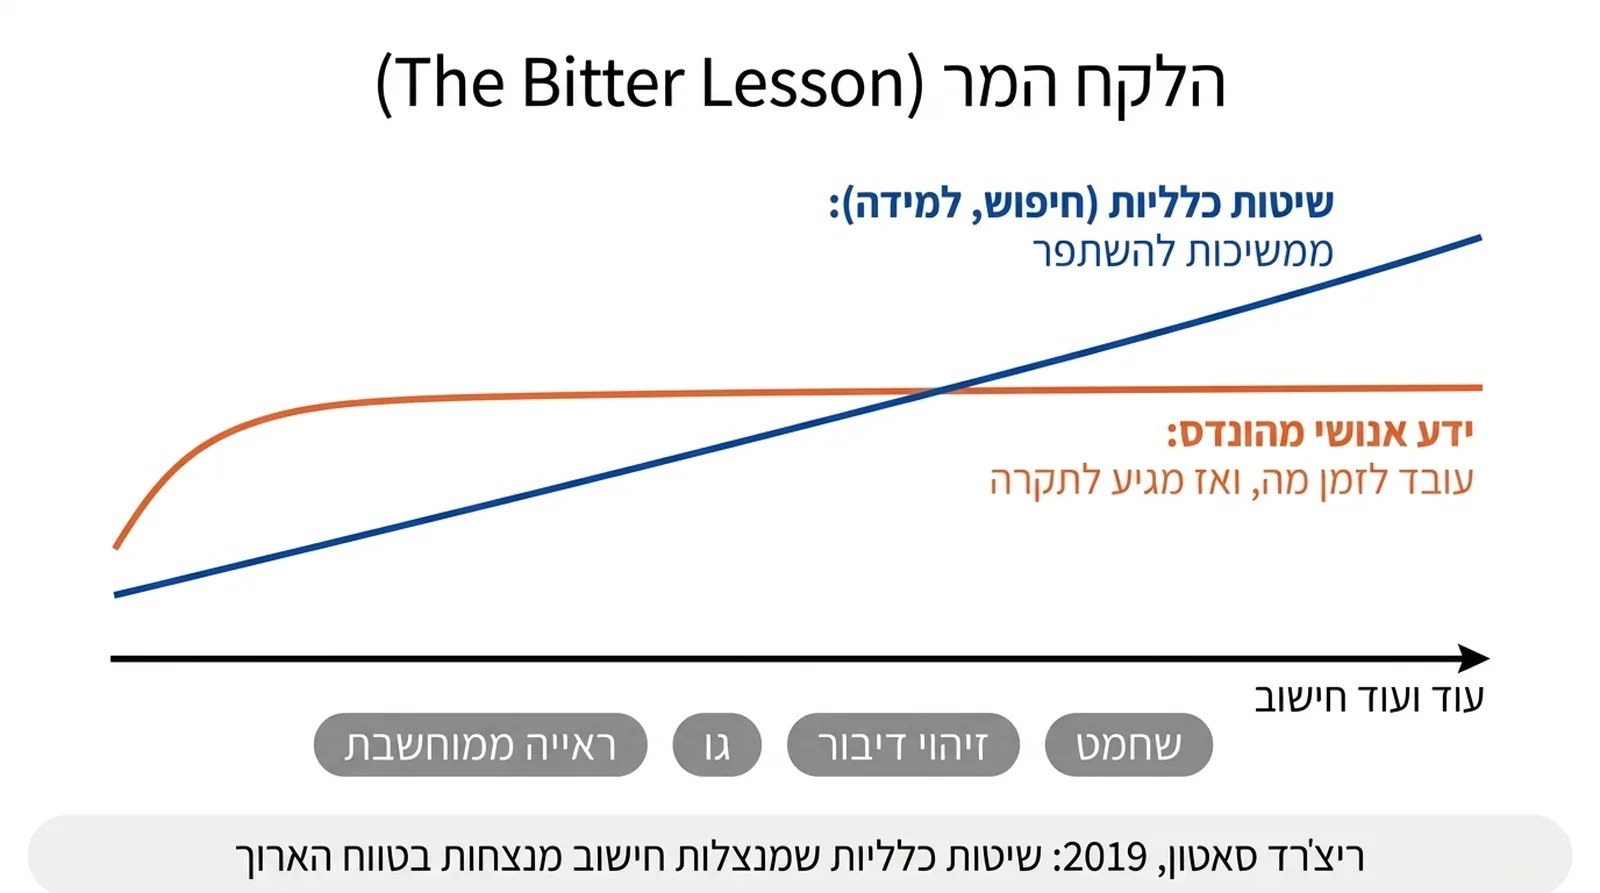
"הלקח המר" (The Bitter Lesson) הוא מאמרו המשפיע של ריצ'רד סאטון מ-13 במרץ 2019: לאורך 70 שנות מחקר-AI, שיטות כלליות שמנצלות עוד ועוד חישוב מנצחות בטווח הארוך גישות מהונדסות-ידע-אנושי ספציפיות-לתחום — עיקרון שערך זה עוסק בו כרעיון, בנפרד מהביוגרפיה של סאטון עצמו.
💡 דוגמה
במשך שנים ניסו ללמד מחשבים שחמט עם הרבה ידע של שחמטאים. מה שניצח בסוף היה פשוט יותר כוח מחשוב ולמידה.
המאמר וטענתו המרכזית
"הלקח המר" (The Bitter Lesson) הוא מאמר קצר ומשפיע שפרסם ריצ'רד סאטון (Richard S. Sutton) — חוקר מוביל בלמידת-חיזוק, פרופסור באוניברסיטת אלברטה וזוכה פרס-טיורינג 2024 (ראו הערך הנפרד העוסק בביוגרפיה שלו) — באתרו האישי incompleteideas.net, ב-13 במרץ 2019. טענתו המרכזית, כפי שמנוסחת בפתיחת המאמר עצמו ומצוטטת בוויקיפדיה: "הלקח הגדול ביותר שאפשר לקרוא מ-70 שנות מחקר-AI הוא ששיטות כלליות שמנצלות חישוב הן בסופו-של-דבר היעילות ביותר, ובפער גדול". במילים אחרות: חוקרים חוזרים ונוהגים להשקיע ידע-אנושי-ספציפי-לתחום במערכות-AI, וזה עובד היטב לזמן-מה — עד שמגיעה שיטה כללית יותר, שמנצלת עוד ועוד חישוב זמין, ועוקפת אותן.
ארבע דוגמאות: שחמט, גו, זיהוי-דיבור, ראיית-מחשב
סאטון תומך את הטענה בארבע דוגמאות היסטוריות (הפרטים הטכניים המדויקים שלהלן, כמו שמות-השיטות הספציפיים, הם ההקשר המתועד מאחורי כל דוגמה, לא ניסוח-מילולי מתוך המאמר עצמו, שכתוב באופן כללי-יותר). בשחמט: Deep Blue הביס את אלוף-העולם באמצעות אלגוריתם-חיפוש (Alpha-Beta Search) פשוט יחסית, מגובה בחומרה ייעודית — לא בהבנה עמוקה של אסטרטגיית-שחמט אנושית, בניגוד לגישות-קודמות שניסו לקודד ידע-שחמט מפורש. במשחק גו: AlphaGo עקף ביצועי-אדם תוך הסתמכות פחותה על ידע-מומחה מקודמיו, ו-AlphaGo Zero לקח זאת צעד-נוסף — הסיר את הידע-האנושי לחלוטין ולמד אך ורק ממשחק-עצמי. בזיהוי-דיבור: מודלים סטטיסטיים כלליים (Hidden Markov Models), שאומנו על כמויות-גדולות של דגימות-דיבור, עקפו את הגישות המהונדסות-ביד של שנות-ה-70, ולמידה עמוקה המשיכה את המגמה. בראיית-מחשב: רשתות-קונבולוציה (CNN) עקפו אלגוריתמים שנועדו לחקות במפורש את מערכת-הראייה האנושית — כולל זיהוי-קצוות (Edge Detection) וזיהוי-תכונות מסוג SIFT.
שתי השיטות שמתרחבות: חיפוש ולמידה
מהדוגמאות האלה סאטון מזקק שתי שיטות-כלליות-בלבד שמפגינות יכולת-הרחבה (Scalability) אמיתית עם עוד ועוד חישוב: חיפוש (Search) — לנסות מספר-עצום של אפשרויות ולדרג אותן — ולמידה (Learning) — להתאים מודל גדול לכמות-עצומה של נתונים. אלה, לטענתו, השיטות היחידות שממשיכות להשתפר ללא-הגבלה ככל שמוסיפים עוד כוח-מחשוב, בניגוד לשיטות מהונדסות-ידע שמגיעות במהירות לתקרת-שיפור, ואז נדרש מאמץ-אנושי הולך-וגדל כדי לשפר אותן עוד קצת.
למה 'מר', ואיך התקבל
הלקח נקרא "מר" משום שהוא פחות אנתרופוצנטרי ממה שרוב-החוקרים ציפו וקיוו — הוא מרמז שההבנה-האנושית-הספציפית שכל-כך משקיעים בה שווה פחות, בטווח-הארוך, מפשוט-להוסיף-עוד-חישוב, ולכן חוקרים התקשו לקבל אותו. עם זאת, מאז פרסומו העיקרון התקבל באופן נרחב: Google DeepMind, במאמר "A Generalist Agent" מ-2022, ניסחו אותו מחדש כך ש"מודלים גנריים שטובים יותר בניצול-חישוב נטו גם לעקוף גישות ספציפיות-לתחום". מחקר מ-2024 שבדק עשרים שנה של תקצירי-כנס-CVPR, כנס-הראייה-הממוחשבת המוביל, מצא "מגמות משמעותיות באימוץ אלגוריתמי-למידה כלליים ובניצול משאבי-חישוב הולכים-וגדלים" — עדות אמפירית לכך שהעיקרון אכן חוזה נכונה לאורך זמן.
הקשר לחוקי-קנה-מידה ולוויכוח על יכולות מתהוות
"הלקח המר" וחוקי-קנה-מידה (Scaling Laws) הם שני צדדים של אותו רעיון: חוקי-קנה-מידה הם הבסיס האמפירי-כמותי לכך ש"עוד חישוב" אכן מתורגם לביצועים טובים יותר בצורה צפויה — בדיוק הטענה שסאטון ניבא באופן איכותי כבר ב-2019, שנה לפני שקפלן ועמיתיו פרסמו נוסחה מדויקת לתופעה. גם הוויכוח על יכולות מתהוות (Emergent Abilities) נוגע לאותו רעיון מזווית אחרת: אם יכולות חדשות אכן "צצות" רק מהוספת-חישוב וגודל, בלי הנדסת-ידע ייעודית, זו תמיכה נוספת בטענת-הבסיס של סאטון — ששיטות כלליות, לא ידע-מהונדס-ביד, הן המנוע האמיתי של ההתקדמות ב-AI.
ניואנס: מה המאמר לא טוען
"הלקח המר" אינו טוען שידע-אנושי חסר-ערך לחלוטין — רק שהוא נוטה להיות פתרון-זמני, לא פתרון-קבוע. מאמר-תגובה בשם "Engineering a Less Artificial Intelligence" מאשר את הכיוון הכללי — "שיטות-גמישות ניצחו עד-כה תמיד ידע-תחום מהונדס-ביד בטווח הארוך" — אך מוסיף הסתייגות חשובה: "בלי ההנחות (המרומזות) הנכונות, הכללה היא בלתי-אפשרית" — כלומר גם שיטה-כללית-לגמרי חייבת איזשהו מבנה-בסיסי מובנה-מראש כדי בכלל ללמוד. מאמר מאוחר-יותר, "The Brain's Bitter Lesson" (2025), טוען שבתחומים מסוימים — כמו זיהוי-דיבור ופענוח-נתוני-מוח — "הלקח עדיין לא נלמד במלואו", כלומר העיקרון נכון בממוצע לאורך זמן, אך אינו נכון באופן אוטומטי ומיידי בכל תת-תחום בכל רגע נתון.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
| גישה מהונדסת-ידע-אנושי | שיטה כללית מבוססת-חישוב | |
|---|---|---|
| שחמט | ניתוח אסטרטגי מקודד-ביד, ידע גרנד-מאסטרים | Deep Blue — חיפוש Alpha-Beta + חומרה ייעודית |
| גו | מנועים מבוססי-ידע-מומחה | AlphaGo, ואז AlphaGo Zero — למידה ממשחק-עצמי בלבד |
| זיהוי-דיבור | כללים פונטיים מהונדסים-ביד (שנות ה-70) | מודלים סטטיסטיים כלליים (HMM), ואז למידה עמוקה |
| ראיית-מחשב | זיהוי-קצוות ותכונות-SIFT מעוצבים-ביד | רשתות-קונבולוציה (CNN) שלומדות תכונות מהנתונים |
שאלות נפוצות ❓
מי כתב את 'הלקח המר' ומתי?
ריצ'רד סאטון, חוקר-למידת-חיזוק מוביל וזוכה פרס-טיורינג 2024, פרסם אותו באתרו האישי ב-13 במרץ 2019.
האם 'הלקח המר' הוא אותו ערך כמו ריצ'רד סאטון עצמו?
לא — זהו ערך נפרד שמתמקד במאמר ובטענה עצמה; הביוגרפיה המלאה של סאטון נמצאת בערך נפרד משלה.
מה שתי השיטות ש'מנצחות' לפי המאמר?
חיפוש (לנסות ולדרג אפשרויות רבות) ולמידה (להתאים מודל גדול לכמות-עצומה של נתונים) — שתיהן משתפרות ללא-הגבלה עם עוד חישוב, בניגוד לשיטות מהונדסות-ידע.
איך זה קשור לחוקי-קנה-מידה?
חוקי-קנה-מידה נותנים לטענה האיכותית של סאטון בסיס כמותי-אמפירי — הם מראים בפועל שביצועים אכן משתפרים בצורה צפויה עם עוד חישוב, נתונים וגודל-מודל.