SWE-bench — מבחן-תקן להערכת סוכני-קידוד על issues אמיתיים מ-GitHub
הגדרה
SWE-bench הוא מבחן-תקן (benchmark) שמעריך סוכני-AI וקידוד לפי יכולתם לפתור issues אמיתיים שנאספו מ-GitHub - לא שאלות מלאכותיות - ומאז פרסומו ב-2023 הפך למדד ההשוואה הנפוץ ביותר לדירוג יכולת-קידוד של סוכנים.
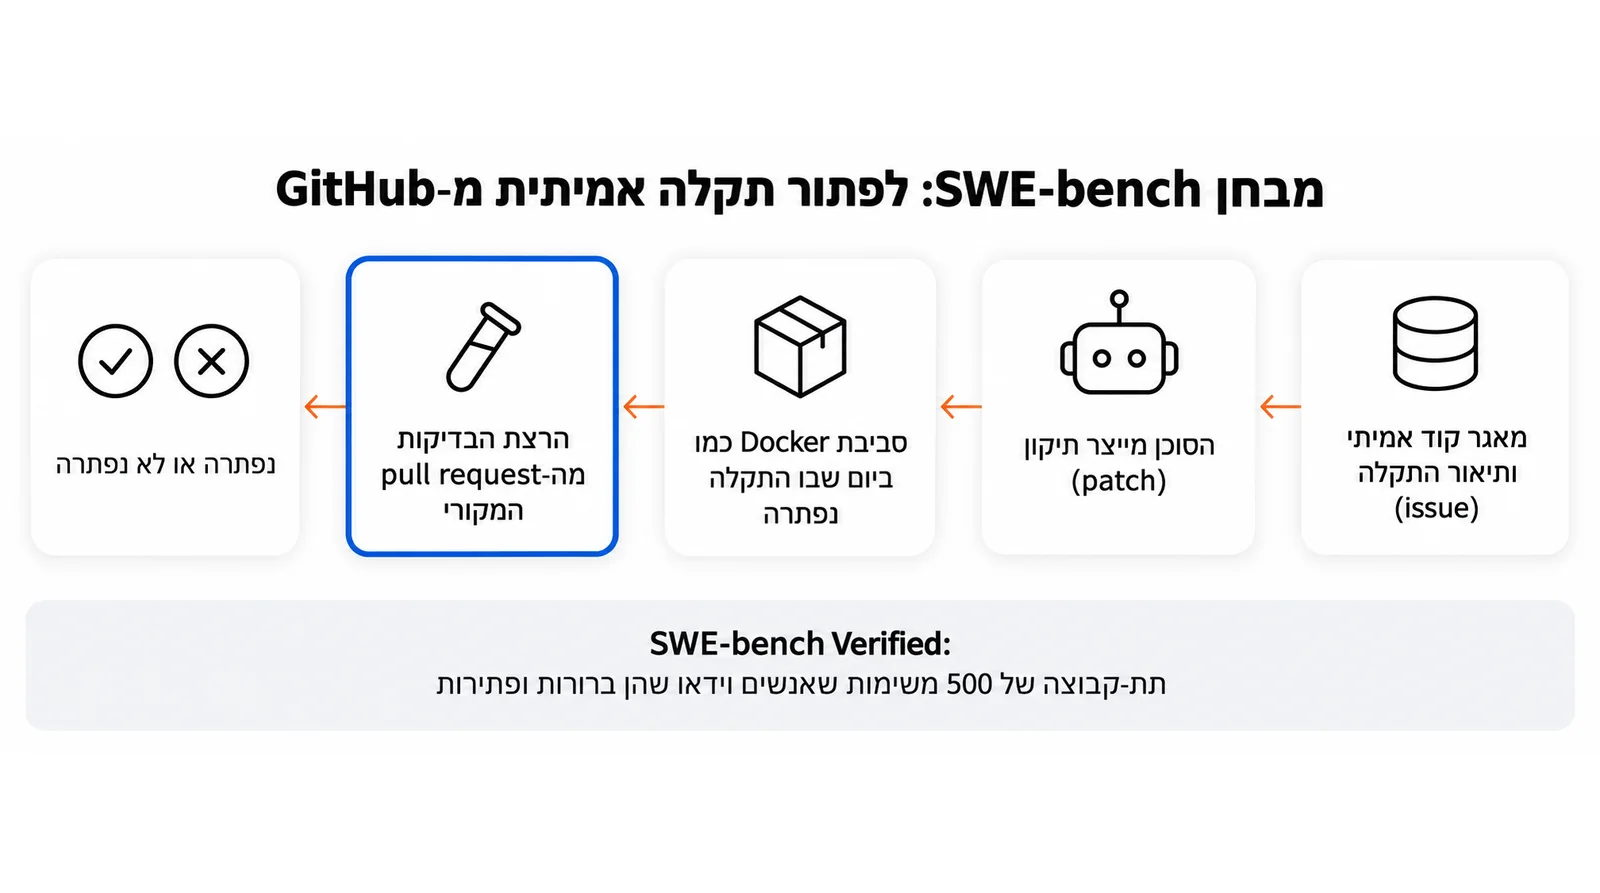
השאלה שהמבחן שואל
לפי הגדרת המפתחים, "SWE-bench הוא מבחן להערכת מודלי-שפה גדולים על בעיות-תוכנה אמיתיות מהעולם, שנאספו מ-GitHub. בהינתן קוד-בסיס (codebase) ותקלה (issue), המודל נדרש לייצר תיקון (patch) שפותר את הבעיה המתוארת". זה שונה מהותית ממבחני-קידוד קודמים כמו HumanEval, שמבקשים לכתוב פונקציה בודדת מאפס מתוך תיאור נקי ומבודד. כאן הסוכן צריך להתמצא בריפוזיטורי אמיתי בן אלפי קבצים, לזהות איפה בדיוק הבעיה יושבת מתוך תיאור-issue שכתב אדם אמיתי (לפעמים מעורפל, לפעמים חלקי), ולתקן אותה בלי לשבור שום דבר אחר.
הפתרון נבדק מול בדיקות-יחידה אמיתיות שנלקחו מה-pull-request שסגר את התקלה בפועל בעולם האמיתי - לא מול תשובת-ייחוס שמישהו כתב במיוחד לצורך המבחן. זו בדיקה קשוחה משמעותית מבדיקה מבוססת-דמיון-טקסטואלי: תיקון יכול להיראות שונה לגמרי מהפתרון המקורי ועדיין לעבור, ובלבד שהוא פותר את הבעיה בפועל.
מקור אקדמי: פרינסטון, ICLR 2024
המבחן הוצג במאמר "SWE-bench: Can Language Models Resolve Real-World GitHub Issues?" מאת קרלוס א. חימנס, ג'ון יאנג, אלכסנדר וטיג, שוניו יאו, קקסין פיי, אופיר פרס וקרתיק נראסימהן, שהוגש ל-arXiv ב-10 באוקטובר 2023 והתקבל כהרצאה-בעל-פה (oral) ב-ICLR 2024 - כנס מהמובילים בתחום למידת-מכונה, שם רק חלק קטן מהמאמרים המתקבלים זוכים למעמד-oral. המאגר הרשמי של הפרויקט נוצר תחת הארגון princeton-nlp ב-GitHub, ומתארח היום תחת ארגון SWE-bench ייעודי משלו.
הגרסה המקורית כללה 2,294 משימות מתוך 12 ריפוזיטוריז בפייתון - כולם פרויקטי-קוד-פתוח אמיתיים ומוכרים, לא קוד-דמה שנכתב במיוחד לצורך המבחן. הנתון שממחיש עד כמה המבחן היה קשה בהשקתו: "המודל בעל-הביצועים-הטובים-ביותר, Claude 2, הצליח לפתור רק 1.96% מהתקלות" - כלומר כמעט כל המשימות נכשלו בהשקה, מה שהפך את המבחן מיד לרף-אתגר משמעותי ולא סתם עוד רשימת-בדיקות קלה שמודלים מובילים פותרים כבר ביום הראשון.
SWE-bench Verified: כשהמבחן עצמו נבדק
מבחן שנבנה אוטומטית מתוך אלפי issues אמיתיים סובל מבעיה טבעית: חלק מהמשימות מנוסחות בעמימות, חלק מהבדיקות פריכות (flaky), וחלק פשוט לא פתירות מהמידע הנתון - למשל כשהתיקון האמיתי הסתמך על ידע-הקשר שלא הופיע בתיאור-ה-issue עצמו. באוגוסט 2024 שוחררה SWE-bench Verified - "תת-קבוצה מסוננת-אנושית של 500 מופעים מתוך SWE-bench, שנוצרה בשיתוף-פעולה עם OpenAI".
לפי האתר הרשמי, מעריכים-אנושיים עברו על כל מופע "כדי לוודא שתיאורי-הבעיה ברורים, שתיקוני-הבדיקה נכונים, והמשימות פתירות בהתחשב במידע הזמין". בפועל זה הפך את Verified לגרסה שרוב הכלים המובילים מדווחים עליה כשהם מכריזים על ציון-SWE-bench, כי היא מנטרלת חלק גדול מהרעש שהיה במבחן המקורי - כלומר כשלון על Verified אומר משהו אמיתי על יכולת-הסוכן, ולא רק שהמבחן עצמו היה מנוסח בצורה בלתי-הוגנת.
משפחת-וריאנטים שגדלה
סביב הגרעין המקורי צמחה משפחה שלמה: SWE-bench Lite היא תת-קבוצה קומפקטית-יותר להרצה מהירה וזולה, מיועדת לצוותי-מחקר שרוצים לבדוק מודל בלי להריץ את כל 2,294 המשימות המלאות. SWE-bench Multimodal בודקת משימות עם רכיב חזותי - screenshot של באג ב-UI, למשל. SWE-bench Multilingual מרחיבה את המבחן מעבר לפייתון בלבד - מגבלה שהוטחה כלפי הגרסה המקורית.
לצד המבחן עצמו התפתחו גם כלים נלווים כמו SWE-agent, SWE-ReX ו-mini-SWE-agent - שלד-סוכן ייעודי שנועד להתמודד עם המשימות שהמבחן מציב, כך שחוקרים שרוצים לבדוק שיטת-סוכן חדשה לא צריכים לבנות תשתית-הרצה מאפס. כל ההרצות משתמשות במיכולי-Docker כדי להבטיח שהערכה תישאר ניתנת-לשחזור בין מעבדות שונות - כלומר שני צוותים שמריצים את אותו מודל על אותה משימה יקבלו את אותה סביבה בדיוק, לא תלויה בגרסת-ספריות מקומית.
איך זה הפך לתקן-מדידה תעשייתי
מה שהתחיל כמבחן-מחקר בודד הפך תוך פחות משנתיים לרף-ההשוואה שמעבדות-AI מובילות מדווחות עליו כשהן טוענות ליכולת-קידוד-סוכנית. כלי-קידוד-סוכניים כמו GitHub Copilot ו-OpenAI Codex, וכן מודלים מובילים אחרים, מוזכרים בשיח התעשייתי דרך ציוני-SWE-bench שלהם - בדיוק כפי שמבחני-ייחוס קודמים בעולם ה-NLP שימשו נקודת-השוואה משותפת בין מודלי-שפה שונים.
העובדה שהמבחן משתמש בקוד-אמיתי מריפוזיטוריז-אמיתיים, ולא בבעיות-צעצוע שנכתבו במיוחד לצורך ההערכה, היא הסיבה המרכזית לכך שהוא נתפס כאמין יותר ממדדים מלאכותיים - וזו בדיוק הסיבה שהוא עונה על קריטריון 'הגדיר את הפרקטיקה': לפני SWE-bench, הערכת-קידוד-סוכני התבססה בעיקר על משימות מבודדות; אחריו, הסטנדרט הפך להיות פתרון תקלות בתוך ריפוזיטוריז-אמיתיים עם היסטוריה, תלויות וקונטקסט-פרויקט מלא.
מגבלות
ככל שציוני-המובילים עולים, עולה גם שאלת-הרוויה (saturation): מבחן שמודלים פותרים כמעט במלואו מפסיק להבחין ביניהם. בפועל, נכון לספטמבר 2026 השאלה הזאת עדיין רחוקה מהכרעה — המוביל ב-SWE-bench Verified עומד על כ-79 אחוזים, ובמבחן המלא בן 2,294 המשימות על כ-53 אחוזים בלבד, כלומר עוד יש מרחב-הבחנה ניכר. זו הסיבה המעשית מאחורי הרחבת המשפחה ל-Multimodal ו-Multilingual - לשמור על רף שעדיין מבדיל בין יכולות בזמן שהגרסה המקורית מתקרבת לרוויה.
מגבלה נוספת, מובנית: המבחן המקורי נבנה כולו מריפוזיטוריז בפייתון, כך שציון גבוה ב-SWE-bench לא בהכרח מנבא ביצועים דומים בשפות-תכנות אחרות כמו Java, Go או Rust - בדיוק הפער שהגרסה ה-Multilingual נועדה לצמצם. מי שמסתמך רק על ציון-SWE-bench-הרגיל כדי לבחור סוכן-קידוד לפרויקט בשפה שאינה פייתון צריך לזכור את המגבלה הזו.
Docker כתשתית-הכרחית, לא רק נוחות
ריצת-הערכה על SWE-bench לא מתבצעת בסביבת-הפיתוח הרגילה של המעריך, אלא בתוך מיכל-Docker ייעודי לכל ריפוזיטורי - כולל גרסת-Python, תלויות וסביבת-מערכת-ההפעלה שהיו קיימות בדיוק ברגע שבו ה-issue המקורי נפתר בעולם האמיתי. זו לא בחירת-נוחות טכנית גרידא: בלי שחזור-סביבה מדויק, תוצאת-הבדיקה (עברה/נכשלה) עלולה להשתנות בין מעבדה למעבדה רק בגלל הבדל בגרסת-ספרייה, לא בגלל הבדל אמיתי ביכולת-הסוכן שנבדק. הדרישה הזו לריפרודוקטיביות קפדנית היא חלק ממה שהעניק ל-SWE-bench את מעמדו כמבחן-אמון: כשחברה מכריזה על ציון מסוים, מעבדות מתחרות יכולות לשחזר את אותה הרצה בדיוק ולוודא שהציון אמיתי, ולא תוצר של סביבת-בדיקה נוחה-מדי.
התלות ב-Docker גם מסבירה למה הרצת-SWE-bench המלא היא משימה כבדה-חישובית: כל אחת מ-2,294 המשימות המקוריות (וכל אחת מ-500 המשימות ב-Verified) דורשת הקמה של סביבה נפרדת, הרצת בדיקות-היחידה המקוריות של הריפוזיטורי, ולעיתים גם הורדת-תלויות מרשת. זו הסיבה המעשית לכך ש-SWE-bench Lite קיימת כתת-קבוצה קומפקטית - לא כל צוות-מחקר מחזיק בתקציב-חישוב הדרוש כדי להריץ את המבחן המלא על כל גרסת-מודל שהוא בודק.
ציון-SWE-bench כשפה שיווקית
תוך פחות משנתיים-שלוש, "פתרנו X% מ-SWE-bench Verified" הפך למשפט שחוזר בהכרזות-מוצר, בפוסטי-בלוג ובהשוואות-תחרותיות בין מעבדות-AI, בדיוק כפי שציוני-דיוק על מבחני-NLP קודמים שימשו בעבר. זה יוצר תמריץ כפול: מצד אחד, זה מדד אובייקטיבי ובר-השוואה שמקשה על טענות-שיווק לא-מבוססות; מצד שני, זה יוצר לחץ לבנות ולכוון סוכנים ספציפית כדי לבצע היטב על המבחן הזה בעצמו, לא רק על משימות-קידוד באופן כללי.
זו בדיוק הסיבה שהאבחנה בין SWE-bench המקורי ל-Verified חשובה כל-כך: מבחן שקל 'לרמות' עליו (בגלל בדיקות רועשות או משימות בלתי-פתירות) מאבד ערך כמדד-שיווקי אמין הרבה יותר מהר ממבחן שעבר סינון-אנושי קפדני - וזו הסיבה שרוב ההכרזות המשמעותיות מצטטות דווקא את Verified, ולא את הגרסה המלאה. אחת ההכרזות המוקדמות שנשענו על המבחן, עוד על גרסתו המקורית, הייתה של Cognition AI, שבמרץ 2024 הציגה את הסוכן Devin וטענה שפתר באופן עצמאי 13.86% מהמשימות במדגם אקראי של רבע מהמבחן, לעומת שיא קודם של 1.96%.
המבחן והפתרון-לדוגמה הם שני דברים נפרדים
החלטת-עיצוב חשובה שקל לפספס: המבחן עצמו לא כופה שיטה מסוימת לפתור את המשימות שלו. SWE-agent, שפותח לצד המבחן, הוא רק שלד-סוכן-לדוגמה אחד מתוך רבים אפשריים - יש לו לולאת-תכנון, יכולת-חיפוש בריפוזיטורי ויכולת-עריכת-קבצים, אבל שום דבר לא מחייב להשתמש בו דווקא. חוקר שרוצה לבדוק ארכיטקטורת-סוכן שונה לגמרי - עם תכנון-רב-שלבי, עם כמה סוכני-משנה, או בלי תכנון מפורש בכלל - יכול פשוט להריץ אותה מול אותו מבחן ולקבל ציון בר-השוואה.
ההפרדה הזו בין 'המבחן' לבין 'הפתרון-לדוגמה' היא בדיוק מה שהופך את SWE-bench לכלי-מדידה תעשייתי ולא רק לפרויקט-מחקר סגור: זה מה שמאפשר לחברות שונות - שכל אחת בונה את הסוכן שלה בשיטה שונה לגמרי - לפרסם ציונים שאפשר להשוות ביניהם בלי לחשוד שההשוואה מוטה לטובת ארכיטקטורה מסוימת.
למה זה שייך לקטגוריית כלים-וסוכנים
SWE-bench עצמו אינו סוכן וגם לא מסגרת-פיתוח - הוא מבחן. אבל הוא זכאי למקום בקטגוריית כלים-וסוכנים כי הוא הגדיר בפועל את הפרוטוקול שדרכו מודדים 'יכולת-סוכן' בהקשר-קידוד: תיאור-issue כקלט, פעולה חופשית על ריפוזיטורי אמיתי כתהליך, ותיקון שעובר בדיקות-אמיתיות כתוצאה. זו תבנית-הערכה שונה מהותית ממה שהיה מקובל קודם (בדיקת פונקציה בודדת מבודדת), והיא זו שאיפשרה להשוות בין ארכיטקטורות-סוכן שונות לגמרי - שלד-סוכן פשוט מול מערכת מרובת-שלבים - על סרגל אחד ומשותף.
במובן הזה SWE-bench ממלא לתחום-הסוכנים תפקיד קרוב למה שמבחנים סטנדרטיים אחרים ממלאים בתחומי-מדידה אחרים: לא כלי שסוכן משתמש בו, אלא הבמה שעליה נמדדת ומושווית ההתקדמות של כלים אחרים בקטגוריה הזו עצמה - כולל כלי-קידוד-סוכניים כמו GitHub Copilot ו-OpenAI Codex.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות
שאלות נפוצות ❓
מי יצר את SWE-bench ומתי?
קבוצת חוקרים מפרינסטון (עם עמיתים), במאמר שהוגש ל-arXiv באוקטובר 2023 והתקבל כהרצאת-oral ב-ICLR 2024. המאמר תיעד ש-Claude 2, המודל המוביל אז, פתר רק 1.96% מהמשימות.
מה זה SWE-bench Verified ולמה היה צריך אותו?
תת-קבוצה של 500 מופעים שעברו סינון-אנושי, שפורסמה באוגוסט 2024 בשיתוף עם OpenAI, כדי לוודא שכל משימה ברורה, פתירה, ומגובה בבדיקה תקינה - ולא סובלת מבעיות-איכות שהיו במבחן המלא.
SWE-bench מעריך סוכן שלם או רק תיקון בודד?
המבחן עצמו מודד את התיקון (patch) שהתקבל מול בדיקות-יחידה אמיתיות; הדרך שבה מתקבל התיקון - סוכן אוטונומי, שלד כמו SWE-agent, או כל שיטה אחרת - פתוחה, וזו הסיבה שהוא משמש להשוואת סוכנים שונים על אותו קנה-מידה.
SWE-bench מוגבל לפייתון?
המבחן המקורי כן, וזו הייתה אחת המגבלות שנמתחה עליו ביקורת בגינה; SWE-bench Multilingual הורחב במפורש כדי לכסות שפות-תכנות נוספות מעבר לפייתון.