הפער הלשוני הדיגיטלי (Digital Language Divide)
הגדרה
הפער בין מיעוט השפות שיש להן נוכחות דיגיטלית עשירה לבין רוב שפות העולם, פער שמשפיע ישירות על איכות מערכות הבינה המלאכותית בכל שפה.
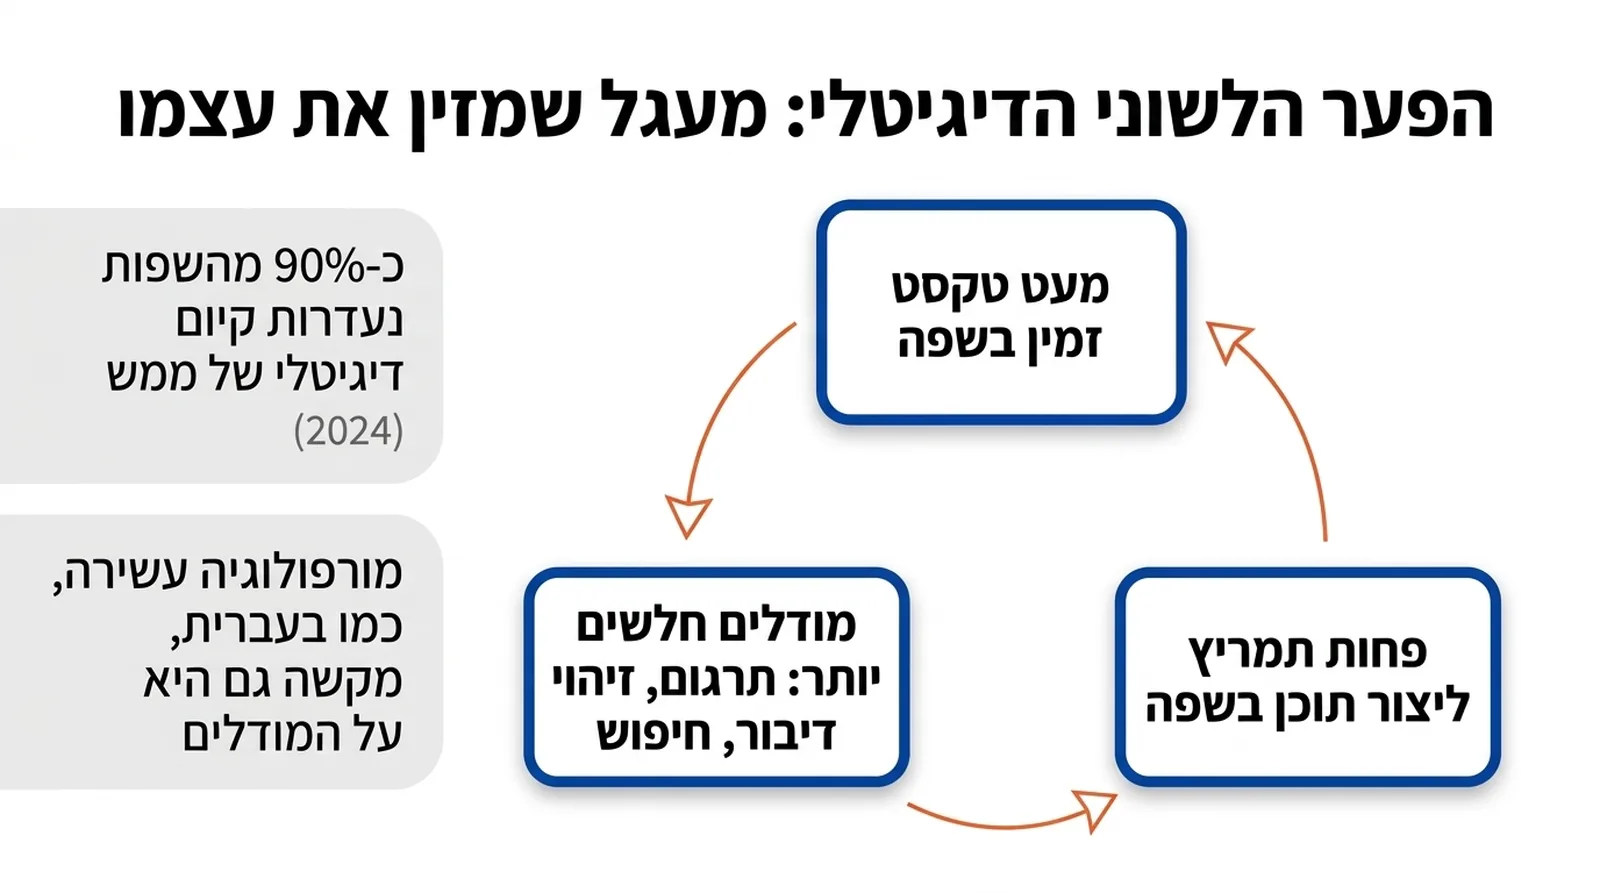
הפער הלשוני הדיגיטלי הוא ההבדל בין מספר קטן של שפות שיש להן נוכחות עשירה ברשת לבין רוב שפות העולם, שכמעט ואינן מיוצגות בה. לפי המצפה לגיוון לשוני ותרבותי באינטרנט, נכון ל-2024 כתשעים אחוזים מן השפות הקיימות נעדרות קיום דיגיטלי של ממש, ובעיקר שפות מיעוט ושפות בסכנת הכחדה; רק כשבע מאות וחמישים שפות זכו לקידוד דיגיטלי מסודר. גם בין השפות שכן מיוצגות הפיזור אינו שוויוני: מתוך כחמישים מיליארד עמודי אינטרנט, כעשרים אחוזים באנגלית וכתשעה-עשר אחוזים בסינית, ואילו ספרדית עומדת על 7.7 אחוזים, הינדי על 3.8, רוסית וערבית על 3.7 כל אחת, צרפתית על 3.4 ופורטוגזית על 3.1. הבלשן דיוויד קריסטל היה מן הראשונים שקראו להכיר בחקר הלשון ברשת כתחום אקדמי בפני עצמו.
לפער הזה יש השלכה ישירה על בינה מלאכותית. מודלי-שפה נבנים מטקסט קיים, ולכן שפה שכמות הטקסט הזמין בה קטנה מקבלת מודלים חלשים יותר — בתרגום, בזיהוי דיבור, בחיפוש ובכל שירות שנשען עליהם. התוצאה מתוארת לעיתים כמעגל: מיעוט תוכן מוביל לכלים גרועים, וכלים גרועים מפחיתים את התמריץ ליצור תוכן. נוסף על כמות הטקסט משפיע גם מבנה השפה: בשפות בעלות מורפולוגיה עשירה, שבהן מילה אחת נושאת מידע דקדוקי רב, פירוק הטקסט ליחידות עיבוד מורכב יותר מאשר באנגלית.
העברית ממחישה את שתי הבעיות ואת הדרך להתמודד איתן. היא שפה בעלת מורפולוגיה עשירה, נכתבת בדרך כלל ללא ניקוד, וכמות הטקסט הזמין בה קטנה בהרבה מזו שבאנגלית. ב-2021 פרסמה קבוצת חוקרים ישראלית — עמית סקר, אלרון בנדל, דן ברקת, עידן ברוסילובסקי, רפאל שקד גרינפלד ורעות צרפתי — את המודל AlephBERT, שאומן על אוצר מילים ועל מאגר נתונים גדולים משל כל מודל עברי קודם, והושג בו שיפור במשימות כמו חלוקה למילים, תיוג חלקי דיבר, זיהוי ישויות וניתוח רגש. המודל פורסם לשימוש חופשי כנקודת פתיחה ליישומי עיבוד שפה טבעית בעברית.
📬 הגיליון השבועי של Wiki-AI
פעם בשבוע, ביום ראשון: שלושת הדברים החשובים שקרו בעולם הבינה המלאכותית, בעברית פשוטה, וערכים חדשים באנציקלופדיה. לגיליונות